
引言
本篇文章将讲解关于客制化的learning rate(Adaptive Learning Rate)的相关信息
一.什么是 Adaptive Learning Rate
自适应学习率方法会根据训练过程中获得的信息,例如某个参数过去的梯度大小,为不同参数或不同训练时刻自动调整有效学习率
二.为什么要使用 Adaptive Learning Rate
有时我们会遇到这种情况,在更新loss的时候,会遇到training stuck,但这不是因为gradient过小导致的
当损失函数在不同方向上的曲率相差很大时,陡峭方向的梯度较大,参数容易在谷底两侧来回振荡,如图所示
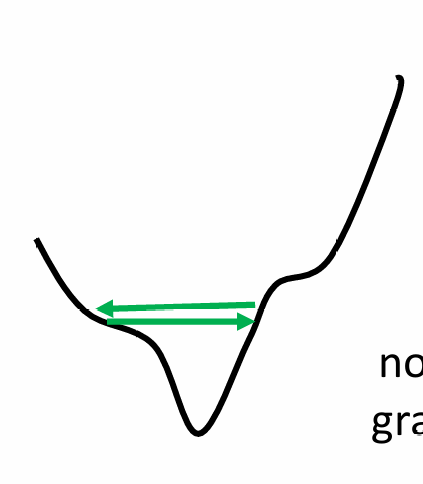
不仅如此,平缓方向的梯度较小,参数沿谷底前进缓慢,单一的全局学习率难以同时兼顾这两个方向,所以我们要在不同的情况下,变化学习速率的大小,而不是每次更新参数的步伐都一致,所以要用到Adaptive Learning Rate
三.如何使用
这里给出通过gradient更新learning rate的公式,这个公式叫做AdaGrad
(本文公式采用课程中基于历史梯度平方均值的表示方式;经典 AdaGrad 通常直接累加历史梯度平方)
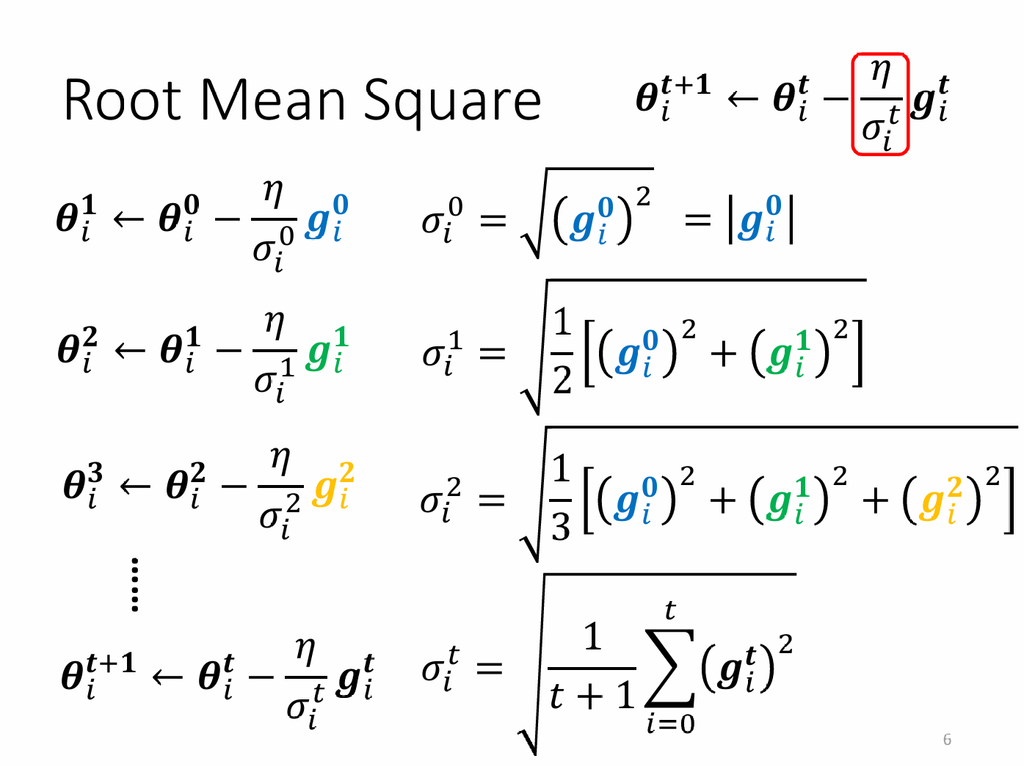
通过这个公式我们可以得到这样的结果:
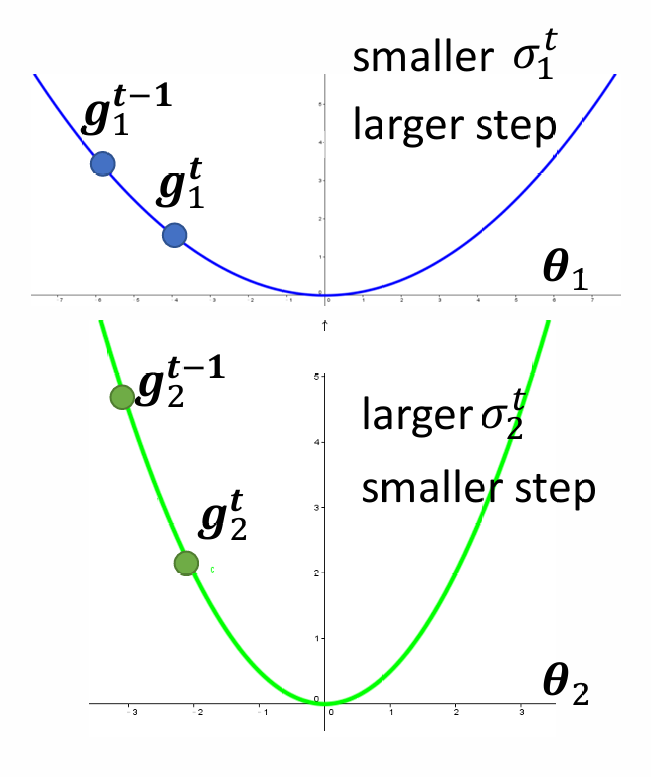
如果某个参数过去的梯度平方较小,它将获得较大的有效学习率;如果过去的梯度平方较大,它将获得较小的有效学习率。最终参数更新量还取决于当前梯度,如图所示
四.RMSProp
但是刚才的计算公式其实并不是最好的,AdaGrad 会累积训练开始以来所有梯度的平方,因此分母通常会持续增大,使有效学习率不断减小,训练时间较长时,学习率可能衰减得过快
这里给出更好的计算公式:RMSProp
RMSProp使用梯度平方的指数加权移动平均,它不会让很久以前的梯度和最近的梯度拥有相同权重,而是更加重视近期梯度,公式如图所示
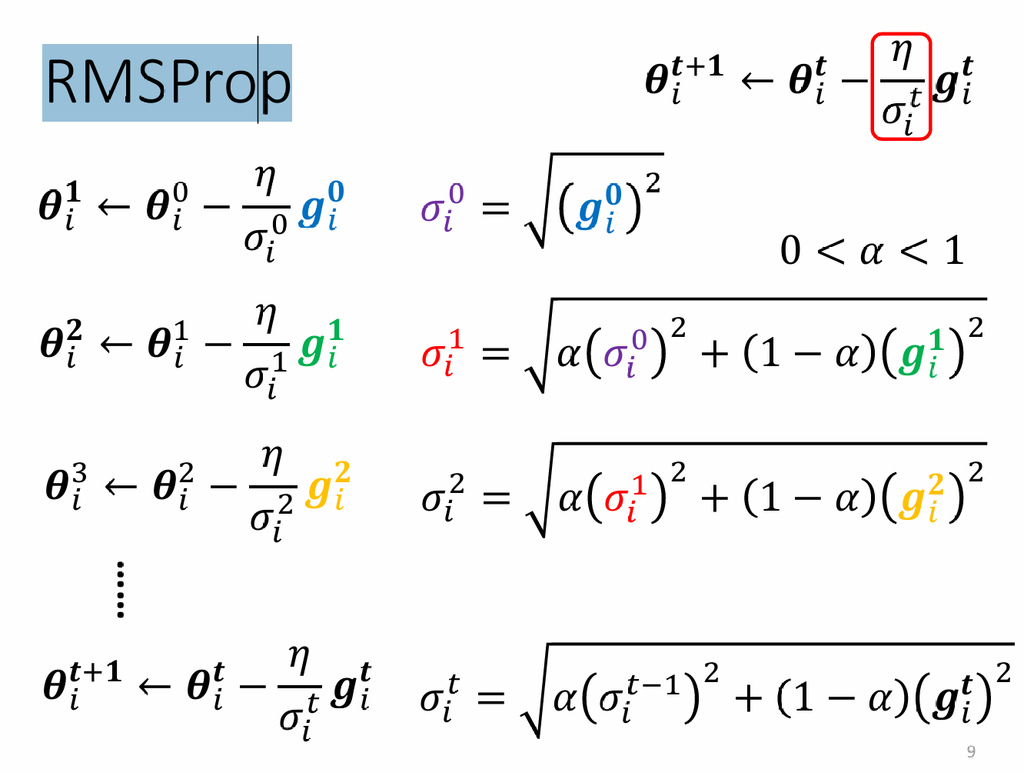
五. Learning Rate Scheduling
除了自适应优化器,还可以使用 Learning Rate Scheduling 调整全局基础学习率,这里给出两种方式
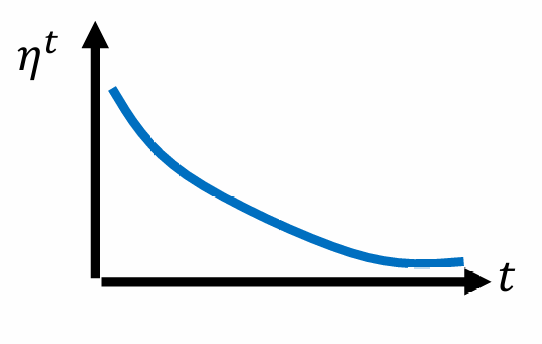
- 1. learning rate Decay
learning rate越来越小,如图
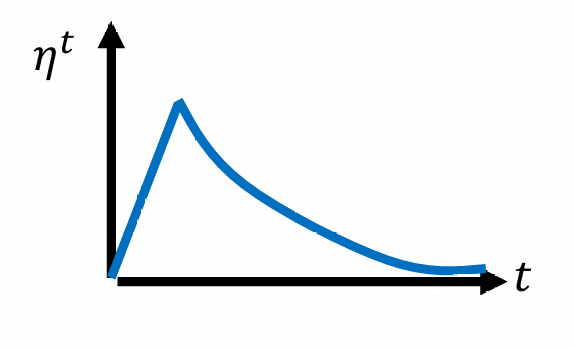
- 2. warm up
Warm up阶段先从一个较小的学习率开始,在若干步内逐渐增大到目标学习率;Warm up结束后,通常再配合恒定学习率或学习率衰减策略
六. Adam
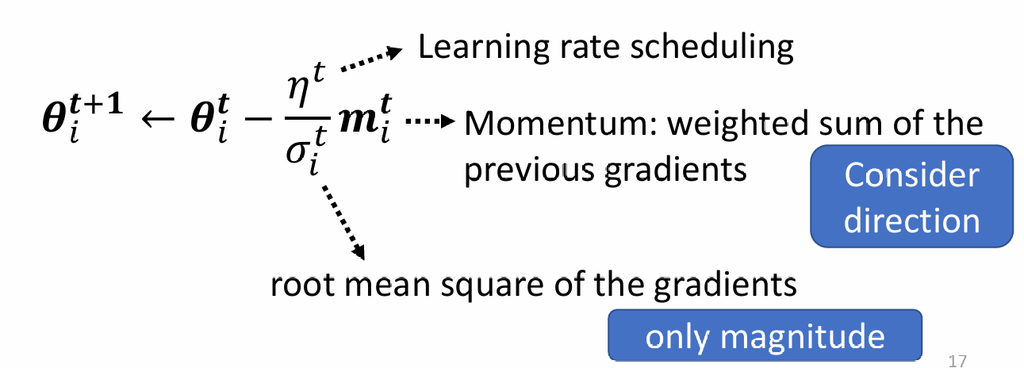
Adam就是最后我们用来optimization比较好的方式,相当于 RMSProp + Momentum
公式如下,m就相当于是Momentum的方向向量
总结
关于optimization的话题就到这里结束了,可喜可贺,可喜可贺
评论(0)
暂无评论