
引言
本篇文章将讲解关于Classification的基础知识
一. 如何理解
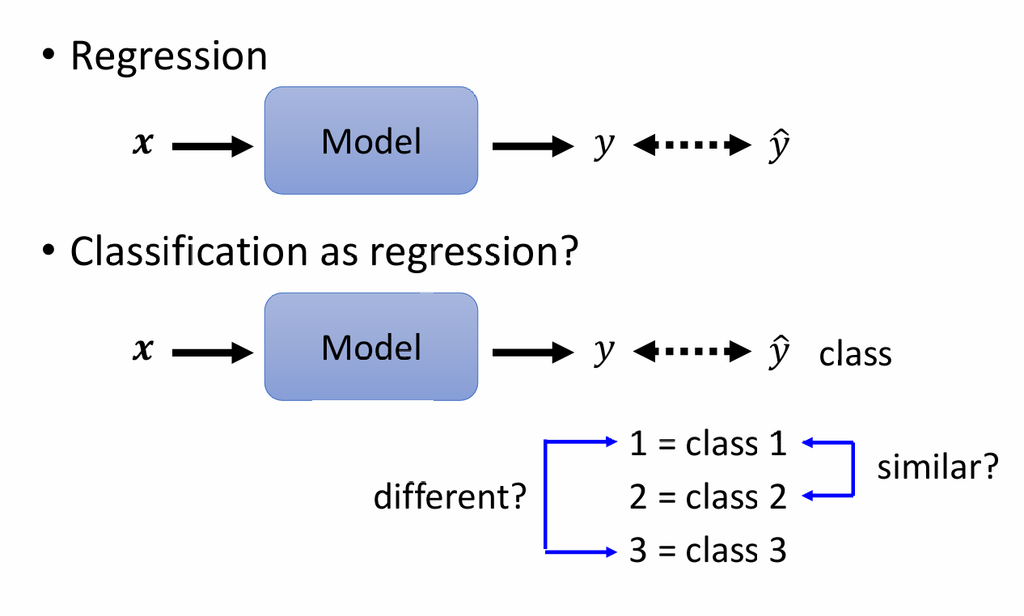
在之前的文章中,我们讲解了regression的内容,相似的,因为分类模型也会先进行数值计算,所以我们可以将Classification看作regression
例如x通过model,regression可以输出一个1,而Classification就可以看做输出一个类型class1,如图所示
二. 如何计算
在多分类任务中,模型通常会输出一个向量,其中每个元素对应一个类别的分数,最后根据这些分数确定预测类别
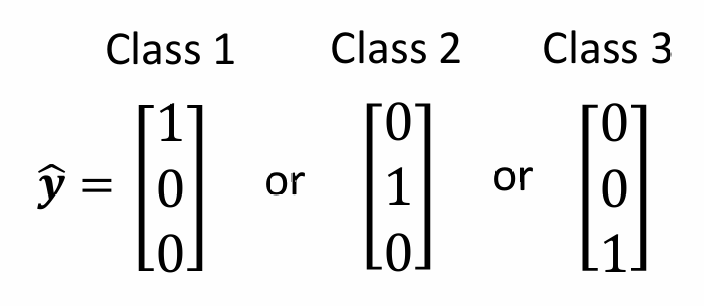
首先,对于互斥的多分类任务,可以使用 one-hot vector 对真实类别进行编码,向量中真实类别对应的位置为1,其余位置为0,如图所示
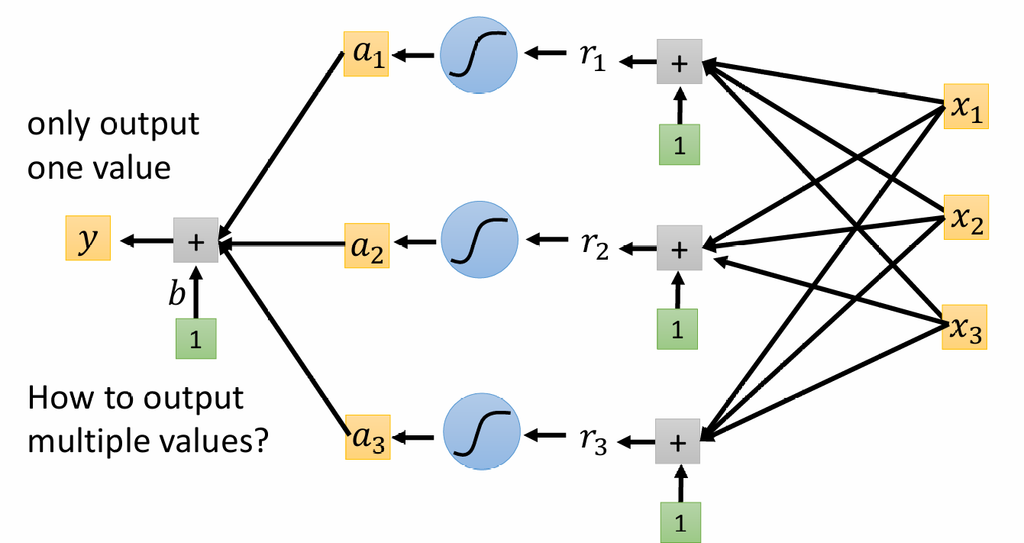
对于具有 个类别的分类任务,模型的输出层通常包含 个神经元,每个神经元使用相应的权重和偏置计算一个类别的分数,这些未经归一化的分数称为 logits,如图所示
模型首先输出一组 logits,logit可以是任意实数,不直接表示概率,Softmax将这些logits转换成和为1的概率分布
Softmax首先对每个logit取指数,使结果为正数;然后用每个指数值除以所有指数值之和,从而得到一个各元素大于0且总和为1的概率分布,如图所示
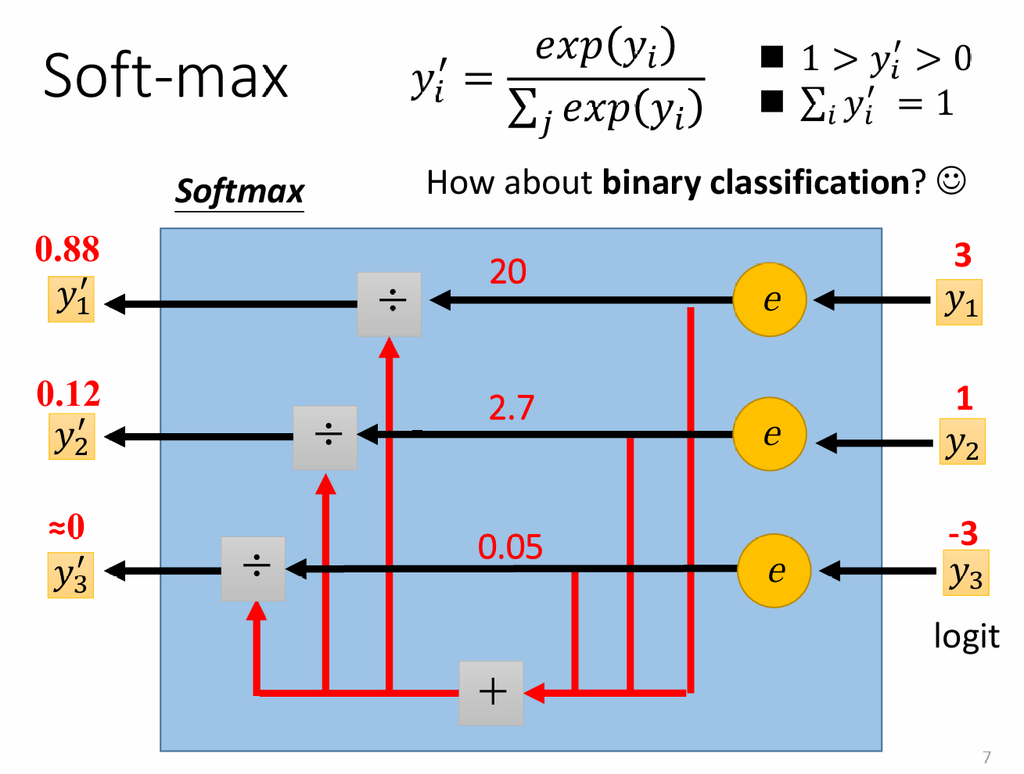
注意这里的0.88,0.12,0都是取得近似值,如图中的结果,0.88最接近1,因此就会默认为class1
三. Loss of Classification
在regression中,我们通常使用MAE或者MSE计算loss的值
但是在Classification中,我们通常使用Cross-entropy计算loss的值,更利于参数的更新,公式如图所示
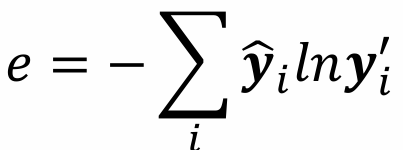
总结
因为我对Classification的理解比较浅薄,所以此篇文章只是讲了很基础的部分
评论(0)
暂无评论