
引言
这篇文章将讲解如何在model不变的情况下对loss,也就是optimization进行优化、
一.Batch
- 1. 定义
Batch是将整个训练集划分成若干小组,每个小组包含一定数量的训练样本,用于一次参数更新
如果看过我写的机器学习概念 – 小园得志这篇文章,你应该会对这张图还有一点印象:
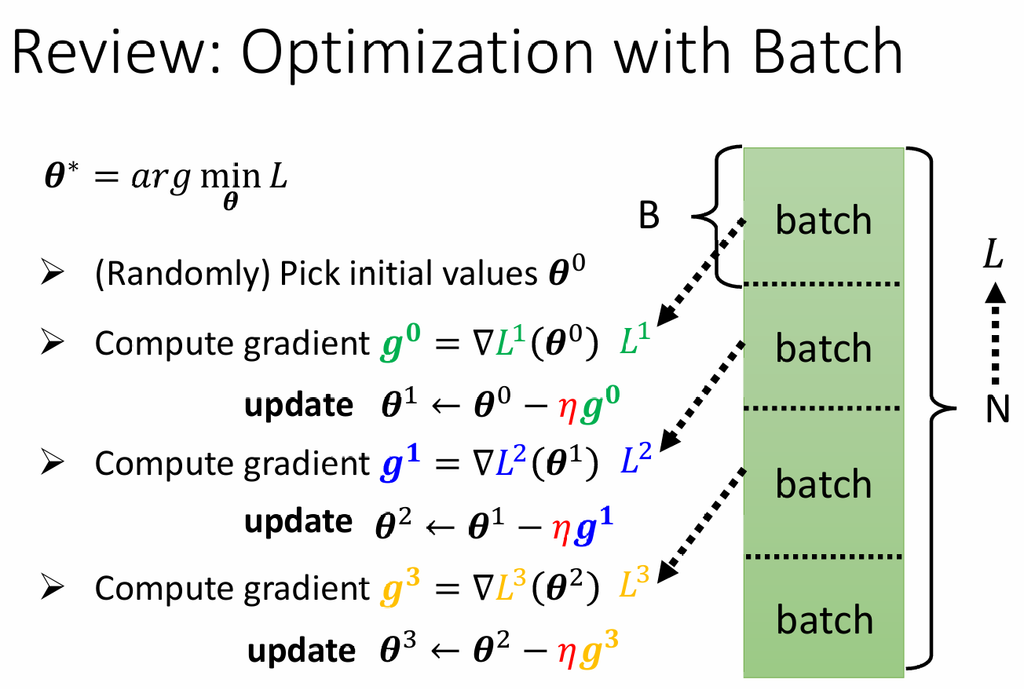
这就是通过batch减少loss的原理,具体解释在机器学习概念 – 小园得志中,有需求的可以自行查看
再给出一个定义
shuffle:shuffle是在每个epoch开始前随机打乱数据顺序,避免模型学习到数据排列规律
- 2. large batch和small batch的对比
2.1 速度
这里直接给出结论:在一定范围内,batch size越大,GPU并行效率越高
2.2 为什么
因为要考虑平行运算,在一定的范围内,GPU处理的速度是相差不大的,例如1000个batch跟1个batch是差不多的,而不是1000倍的关系,Large batch减少每个epoch中的update次数,因此完成一个epoch通常更快
2.3 哪个好
一般来说,小的batch得到的结果会更好,大的batch往往会得到差结果,造成optimization issue
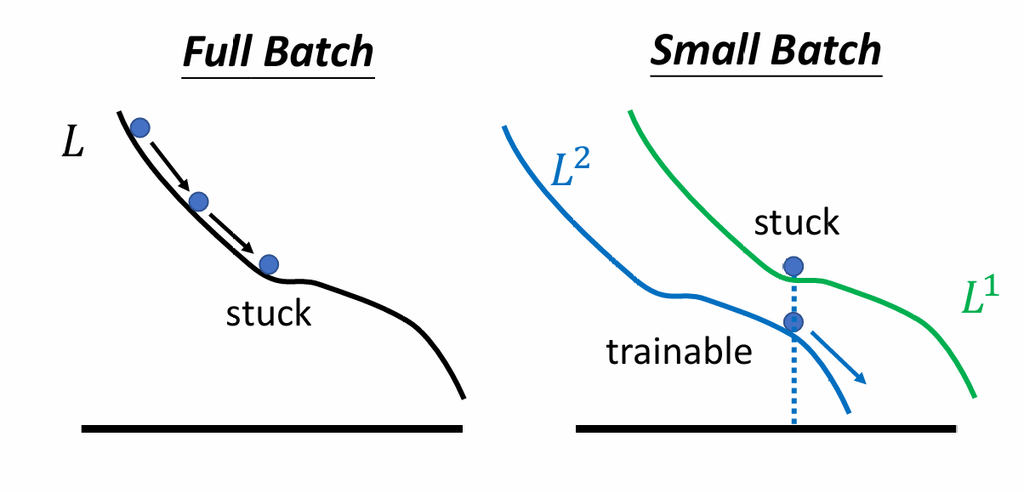
因为small batch具有梯度噪声,有助于优化和泛化,Large batch梯度过于稳定,在某些平坦区域或saddle point附近可能缺少跳出的能力,如图
但是batch过小也会出问题,会造成overfitting
2.4 总结
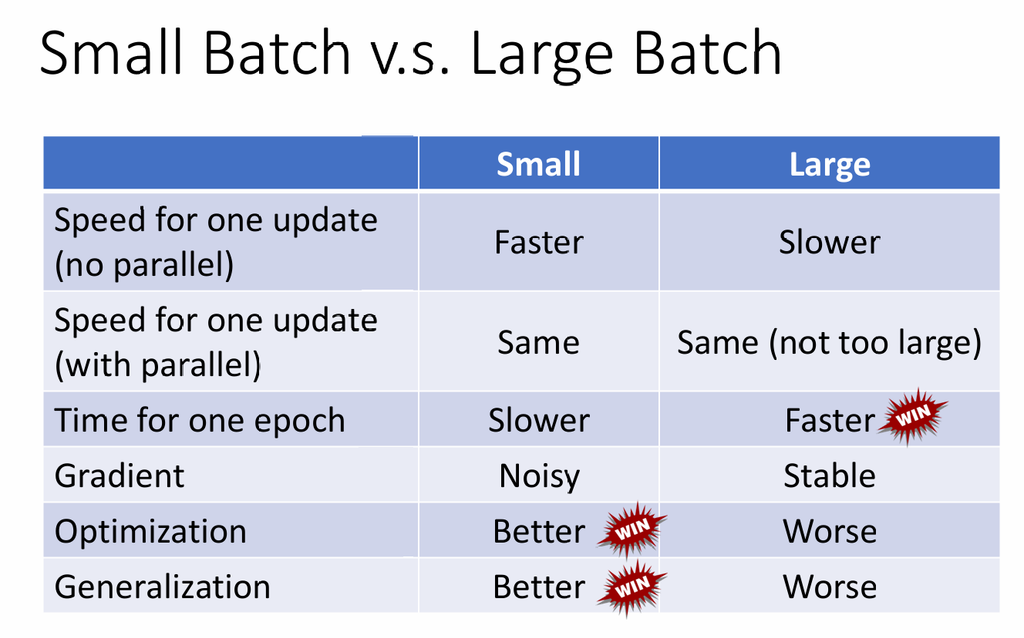
大的batch运算快,小的batch结果准
这里再附上一张对比图,有助于你更好的理解
二.Momentum
- 1. 概念
可以想象成一个物理模型,在一个坡上面滚动,但是带有惯性,在到达一些低谷时也能依靠惯性继续运动,如图:
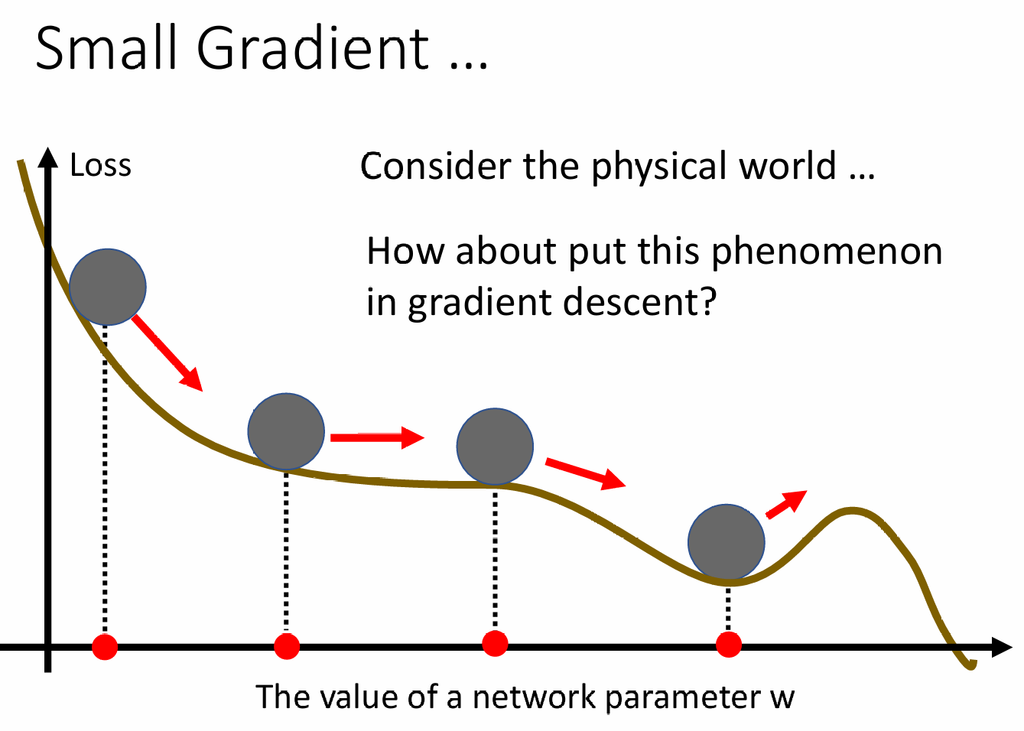
Momentum可以理解为带有惯性的梯度下降方法,参数更新不仅考虑当前gradient,还考虑之前的运动方向
- 2. 作用
我们要做的就是将gradient decent与momentum结合起来
gradeien decent对于参数的更新是根据梯度找到loss减少的方向,并且向此处更新,但如果gradient为接近0,就可能会造成saddle point
相对的,将gradient decent与momentum结合起来,减少梯度接近0时参数停止更新的情况,提高逃离saddle point和狭长区域的能力
- 3. 如何计算
与momentum结合,相当于加上了惯性,也就是看上一次参数更新的方向,然后将两者按向量相加,这里给出一个示意图
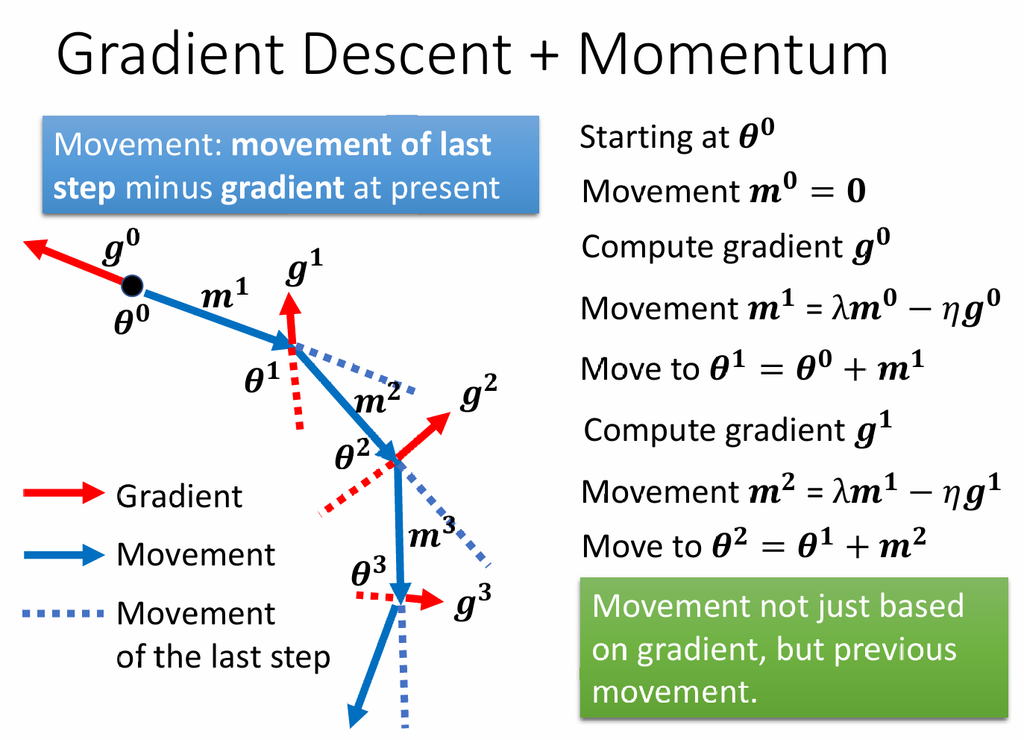
红色箭头表示当前gradient方向;蓝色虚线表示上一轮参数更新方向;蓝色实线表示结合历史运动和当前gradient后的实际参数更新方向
总结
同过本章的知识,灵活运用batch跟momentum的知识,可以更好地实现optimization,希望对你有帮助
评论(0)
暂无评论