
引言
CNN全称为Convolutional Neural Network,中文叫卷积网络
一. 意义
CNN 最经典、最常见的应用之一是图像分类,但 CNN 本质上是一种擅长处理具有空间局部结构数据的神经网络
二. 图片
- 1. 图片构成
首先我们先来讲解一下在机器学习中图片的构成
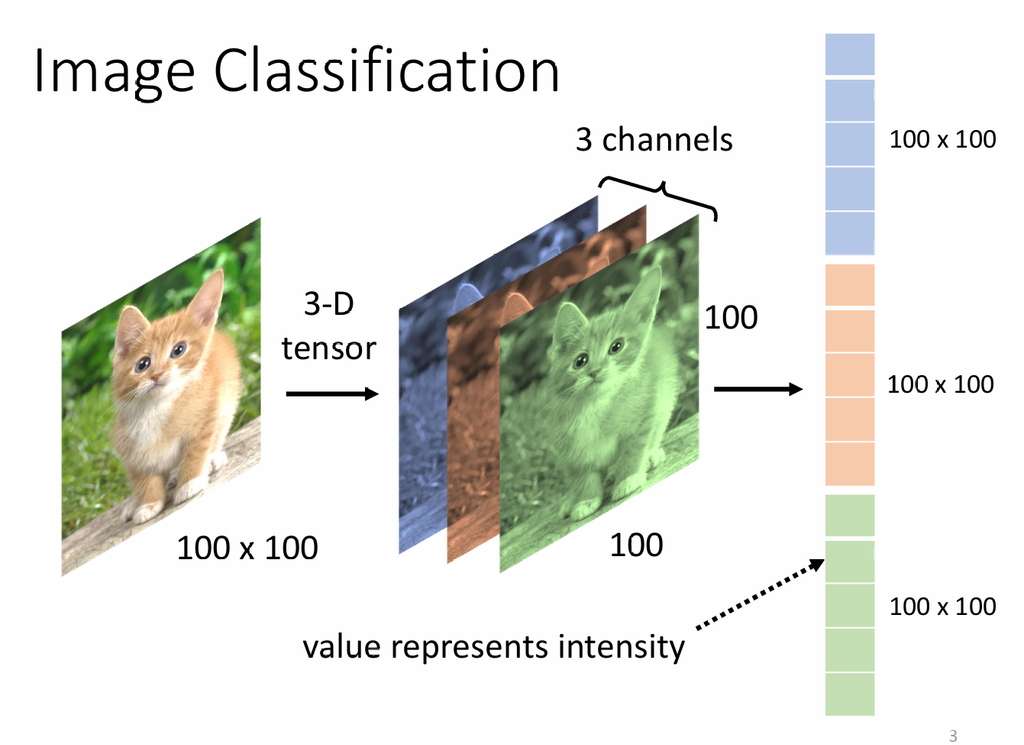
图片通常由长,宽,channels(通道数构成),channels一般是3,包括RGB,如图所示
- 2. 如何读取
例如一张 100×100 的 RGB 图片可以表示为一个 100×100×3 的三维张量,其中三个 channel 分别对应 R、G、B。若输入普通全连接网络,需要将其展平成一个 30000 维向量
然后我们再将这些向量交给神经元,神经元再依次去分析输入值得出结果,也就是常用的fully connected如图
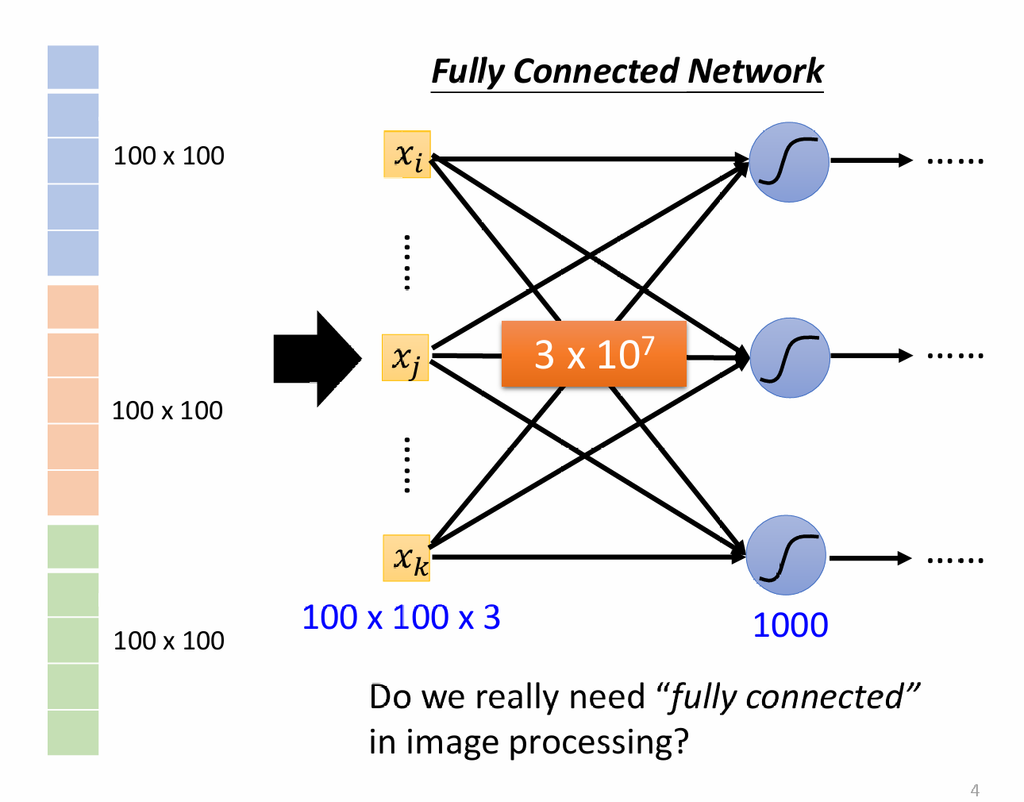
但是我们真的需要fully connected吗,可以看到在上图中,如果直接将 100×100×3 的图片展平后连接到一个包含 1000 个神经元的全连接层,那么仅这一层就需要约 3000 万个权重参数
对于人来说,辨别一个物体一般也是通过部位来辨别的,同样的我们也可以将它使用到图片分类中,因此就引出了CNN
三. 如何辨别
CNN主要分为两个阶段,特征提取阶段和分类 / 输出阶段
- 1. Obersation1
首先我们要明确的是不需要neuron一次性观看全部图片,而是通过窗口的方式分别观察,现在再详细的进行讲解
Simplification 1:
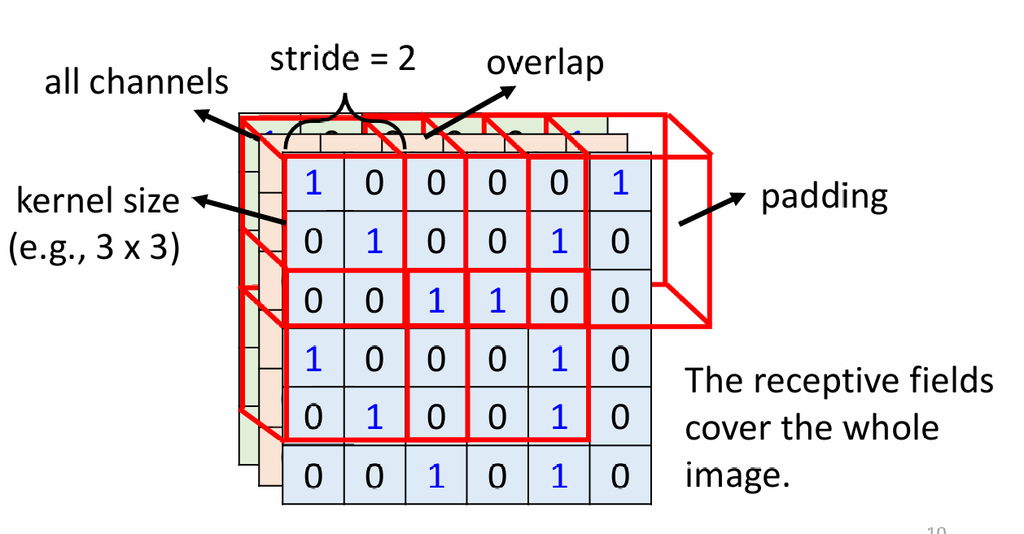
a. 设定卷积核大小(kernel),从而决定当前卷积层的局部感受野大小,kernel决定了feild的大小
b. 每个输出神经元只与其对应的 receptive field 中的输入相连接
c. 彼此之间的field是可以重叠的
d. 对同一个 receptive field,可以使用多个不同的 filter / kernel(参数) 进行特征提取
e. filter存在深度,例如一个3×3的field,不仅只是有9个filter,而是还要考虑channel,例如有RGB,因此filter的数量为3×3×3
这里再给出一个最经典的设置方法:
a. 将三个channel都分析一遍
b. 一个 filter 在某个空间位置进行一次卷积计算,可以对应一个输出 neuron,多个 filters 会在这个位置产生多个 neuron 的输出
c. 将field按照stride(卷积核每次移动多少格)进行移动,形成一个新的field,并且希望这些field有重叠)
d. field超出了范围,就利用padding(补充空位),常用0进行补位
- 2. Observation 2
同一种视觉特征可能出现在图像的不同空间位置,因此没有必要为每个位置分别学习一套独立参数
Simplification 2:
对于这些部位,同一个 filter 在不同空间位置使用相同的一组参数
目的是减少参数量,并且同一种特征可以在图像不同位置被检测出来
如何做到:
一个卷积层包含多个 filters,每个 filter 拥有自己的一组可学习参数,每一个 neuron 对应一组相同的参数,如图所示
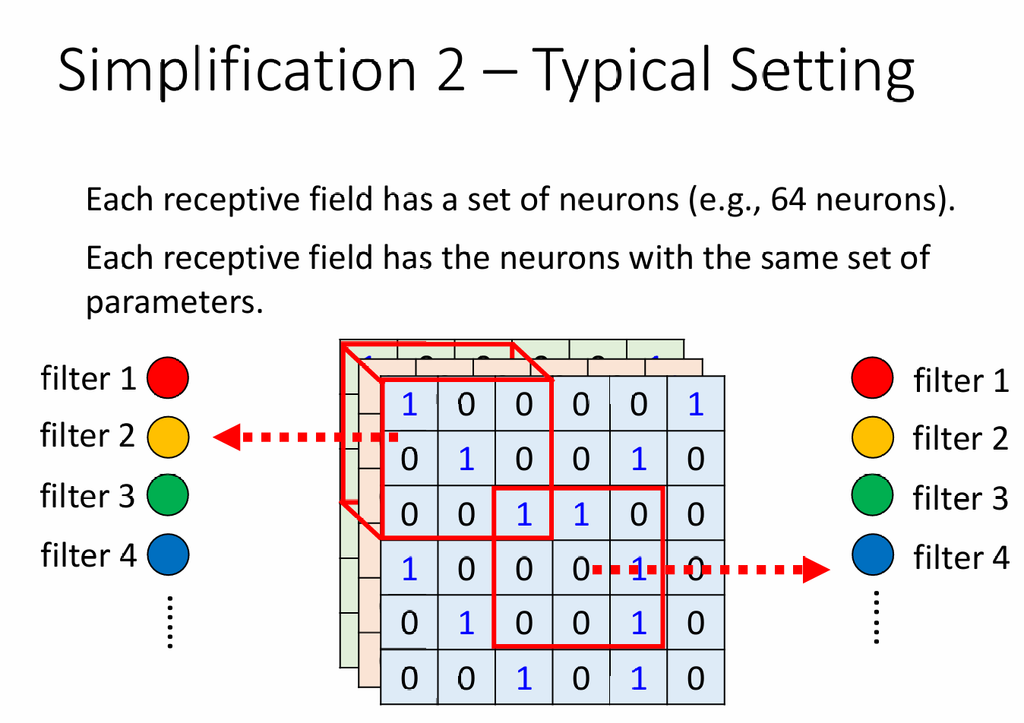
不止如此,减少了参数,间接增加了bias,对于影像分类,反而可以防止overfitting,可以做的更好
四. 总结
一个 filter 是一组可学习参数;它在整张输入特征图上滑动,同一个 filter 在不同位置使用完全相同的参数;filter 每到一个位置进行一次计算,就得到该位置的一个 neuron 输出,多个 filter 则产生多个 output channels
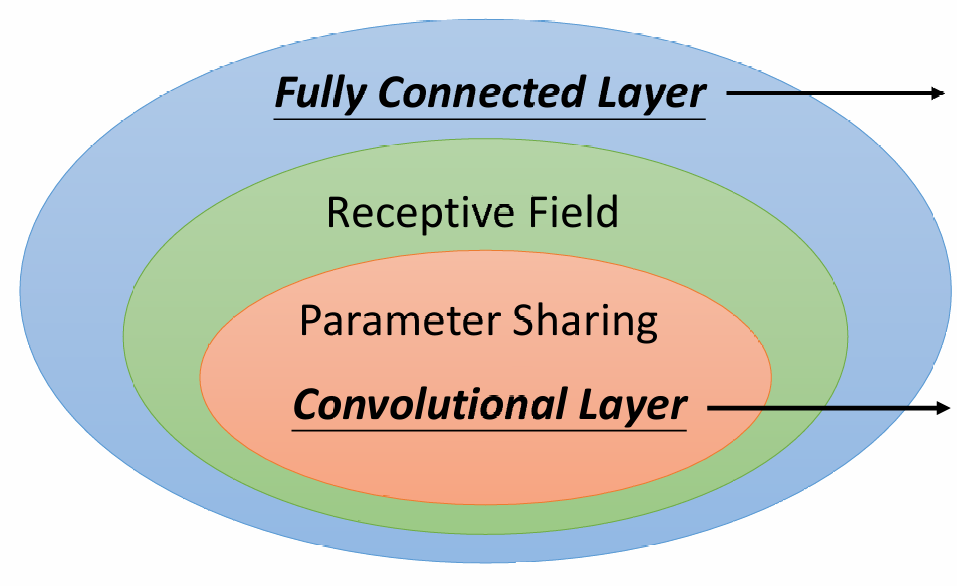
结尾
这个理解起来费了我好大的功夫,也算是有回报吧
评论(0)
暂无评论