
引言
在之前我们已经学习了输入多个值输出一个值,输出多个值输出相同数量的值,但是还有一种,也就是输入一定数量的值但是输出值的数量有机器决定,这一篇文章将会讲解这个问题
一. Sequence-to-sequence
- 1. 定义
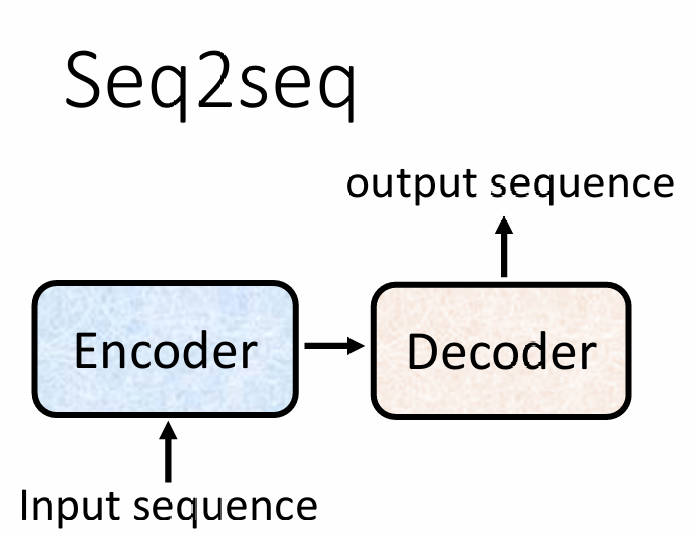
输入一定数量的值但是输出值的数量有机器决定,这一种类型我们把它叫做Sequence-to-sequence
简写就是Seq2seq
而本章的标题Transformer是实现 Seq2Seq 的一种架构
- 2. 用途
Seq2seq常用于语音辨识,机器翻译,语音翻译,文法剖析等领域,由此可见它的用途是很广的
二. Seq2seq的运行
- 1. 总述
Seq2Seq 将输入序列映射为输出序列,其中 Encoder 将整个输入序列编码为上下文表示,Decoder 在这些表示的条件下生成目标序列
- 2. Encoder
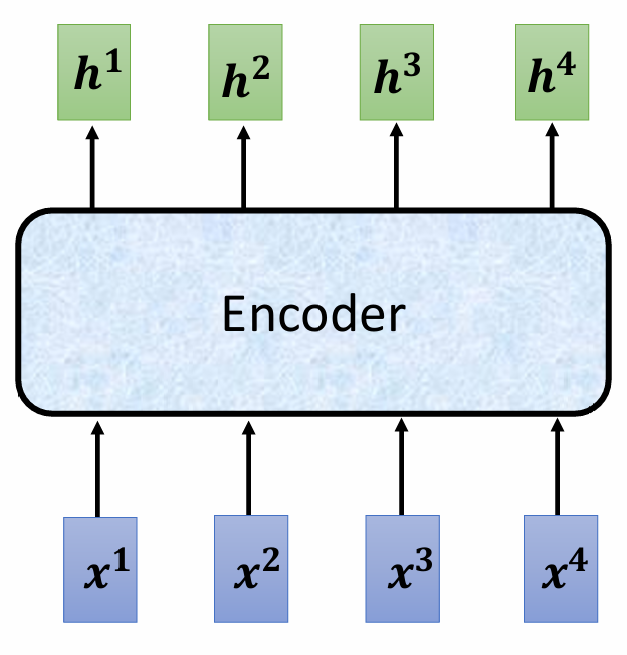
相当于给一排向量,输出相同数量的向量,类似于Self-attention
Encoder的工作原理如图:
而我们在本篇文章中使用的方法Transformer的细节是这样的
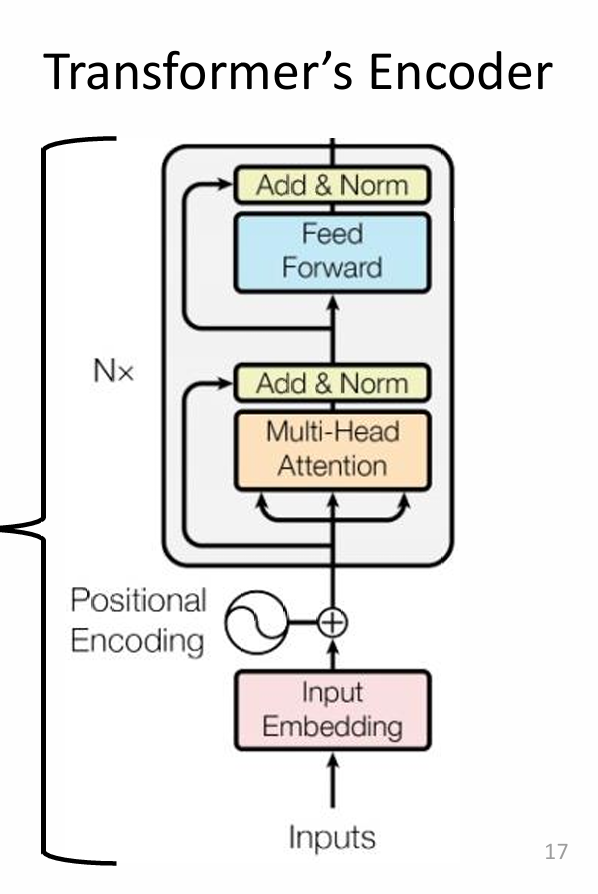
这个图看起来很复杂,我们现在开始一步一步的解释他
首先Encoder并不是只执行一次这张图,而是执行n次,将其封装成了很多个block,如图
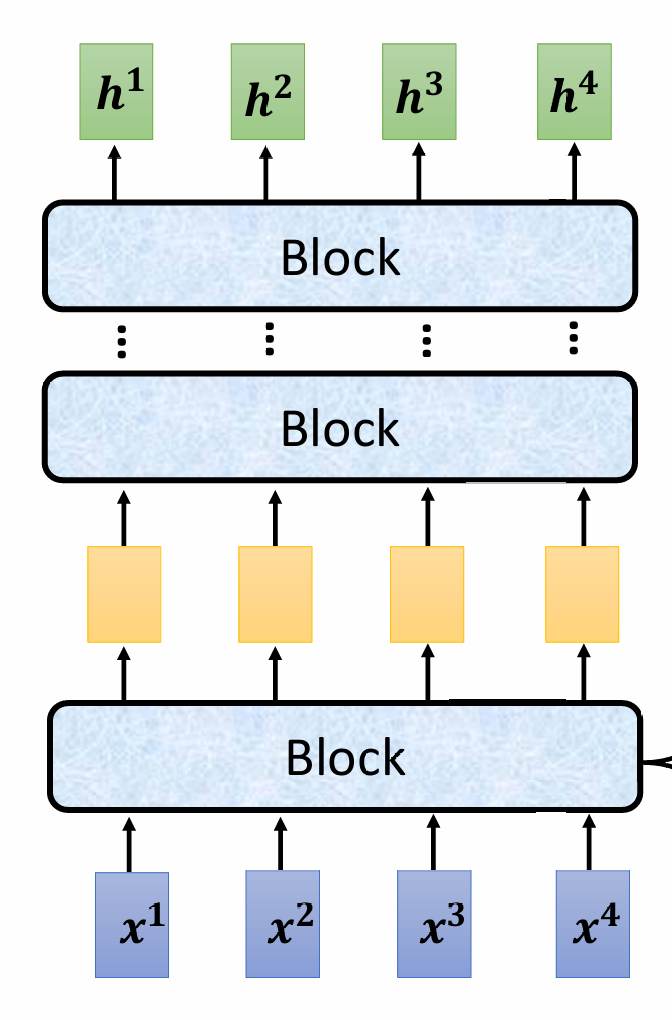
我们要解释的就是block里面有什么
在上文我们说过Encoder类似于Self-attention,但事实上,Transformer也确实使用的就是Self-attention,再进行FC处理,这就是一个block,如图
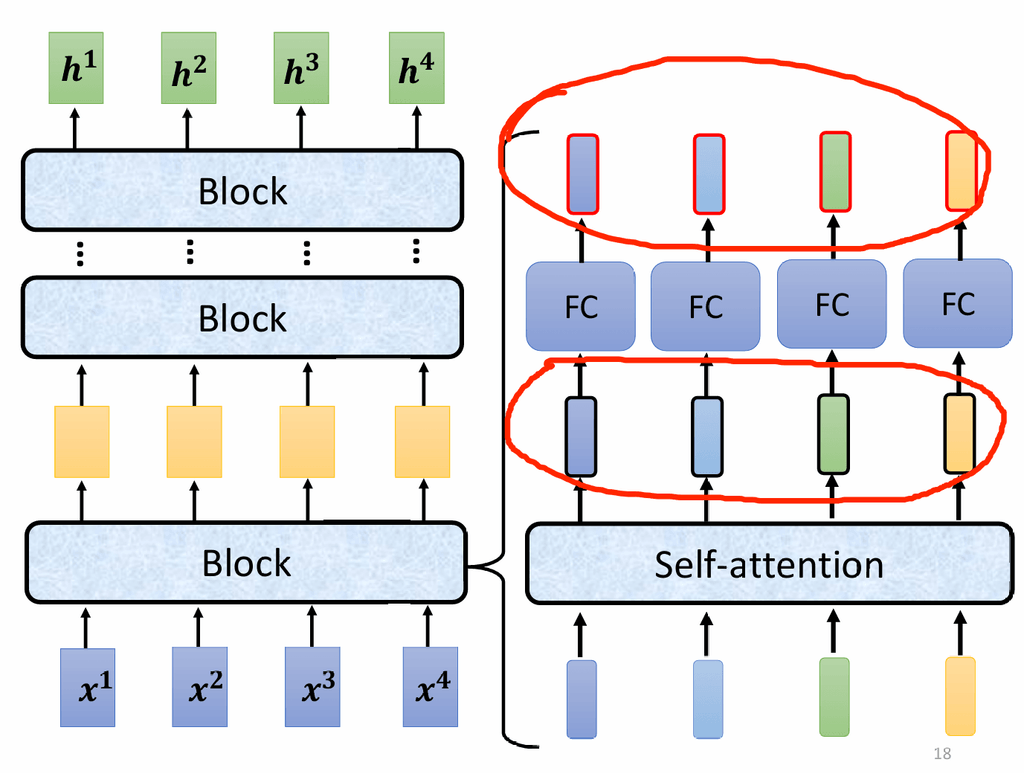
但是注意到,这里面我画圈的地方还要经过处理,并不只是单纯的Self-attention和FC的输出结果
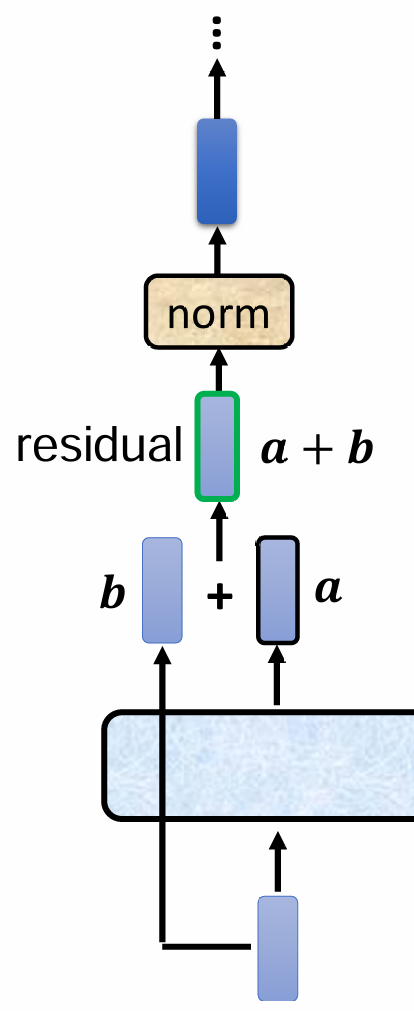
这里的输出结果还要再加上输入self-attention和输入FC的值,也就是residual a + b,如图所示
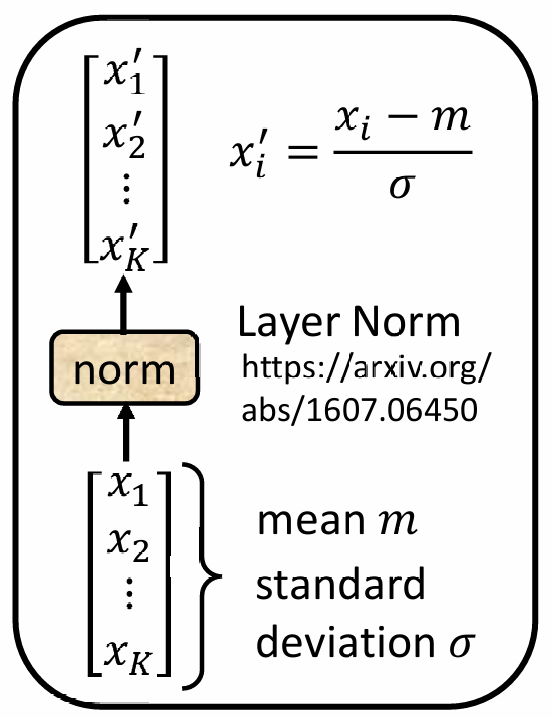
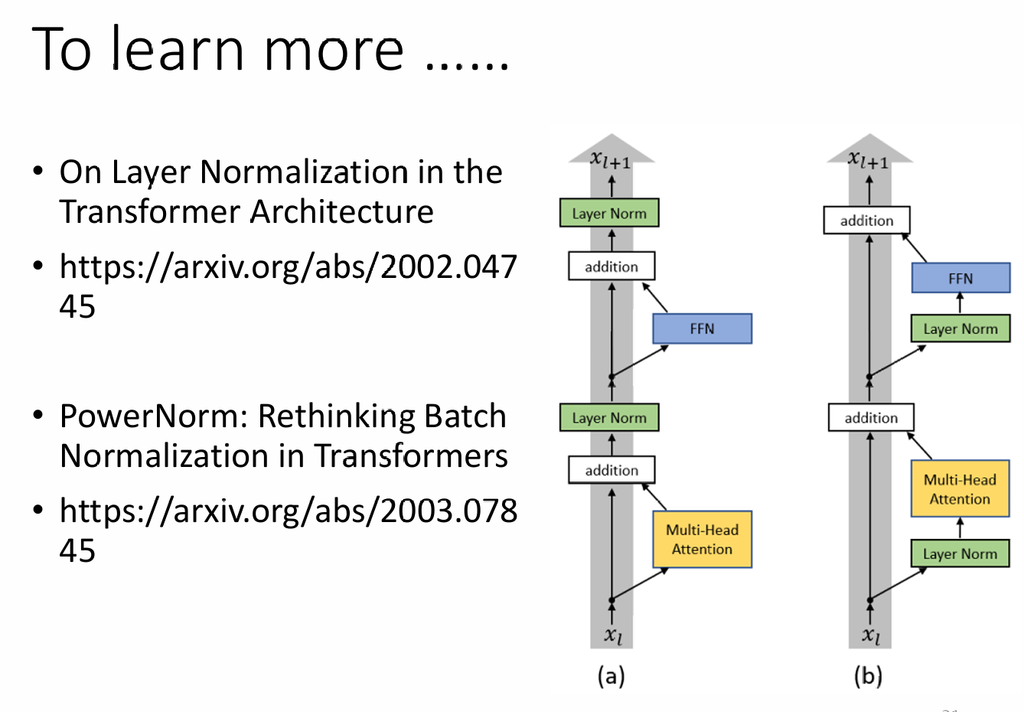
在上一篇文章我讲解过关于batch normalization的知识(Batch Normalization – 小园得志),这里同样也要用到normalization的知识,但是这里使用的是layer normalization
layer normalization不同的是,不是对整批 token 的同一维度求均值,它是对同一个token的不同梯度进行normalization,如图所示
那为什么这里要使用layer normalization呢?
原因是因为在transformer中,每个向量的输出不依赖 batch 和序列长度,并且能稳定深层网络中每一层的数值分布和梯度传播
ps:layer normalization的顺序也不一定是固定的,因为有人发现在一些情况下,不同的顺序结果也可能会更好,这里给出链接,可以进行自我学习
- 3. Decoder
3.1 Autoregressive
先通过Encoder的输出值,当作begin输出第一个值,再将输出的这个值当作下一个输入值,再输出下一个值,如图
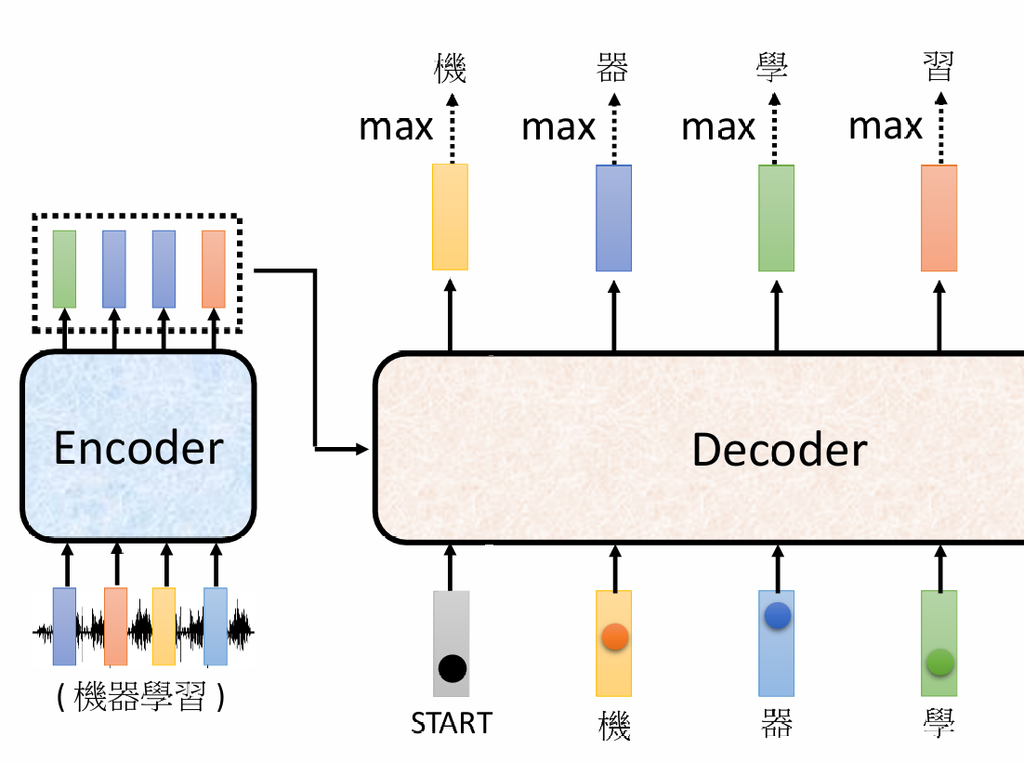
当然这只是简述,具体还分了细节,我们来观看具体的运作图
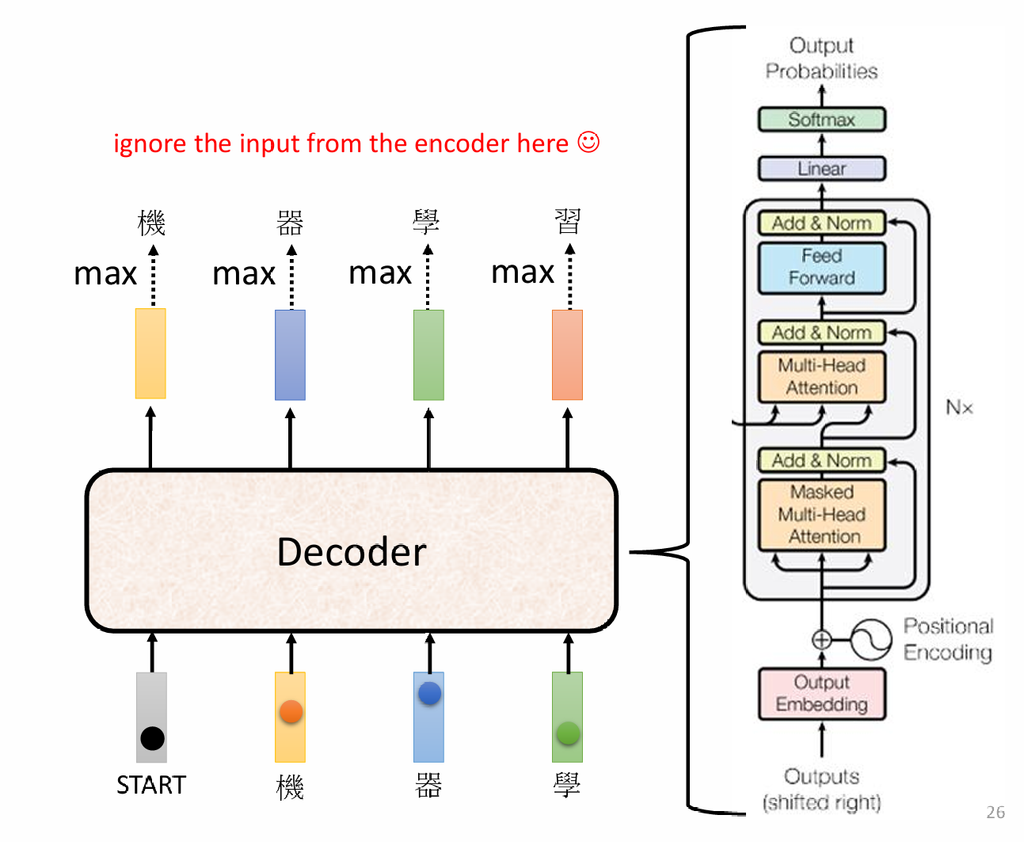
我们可以发现右图中的具体运作图是与Encoder是很相像的,但是多了一部分,并且Self-attention的类型不一样,
这里先讲解关于Self-attention类型不同的问题
- a. Masked Self-attention
在处理数据的过程中也使用了Self-attention,但是加了限定,不考虑全部的位置,只考虑当前位置和之前的位置
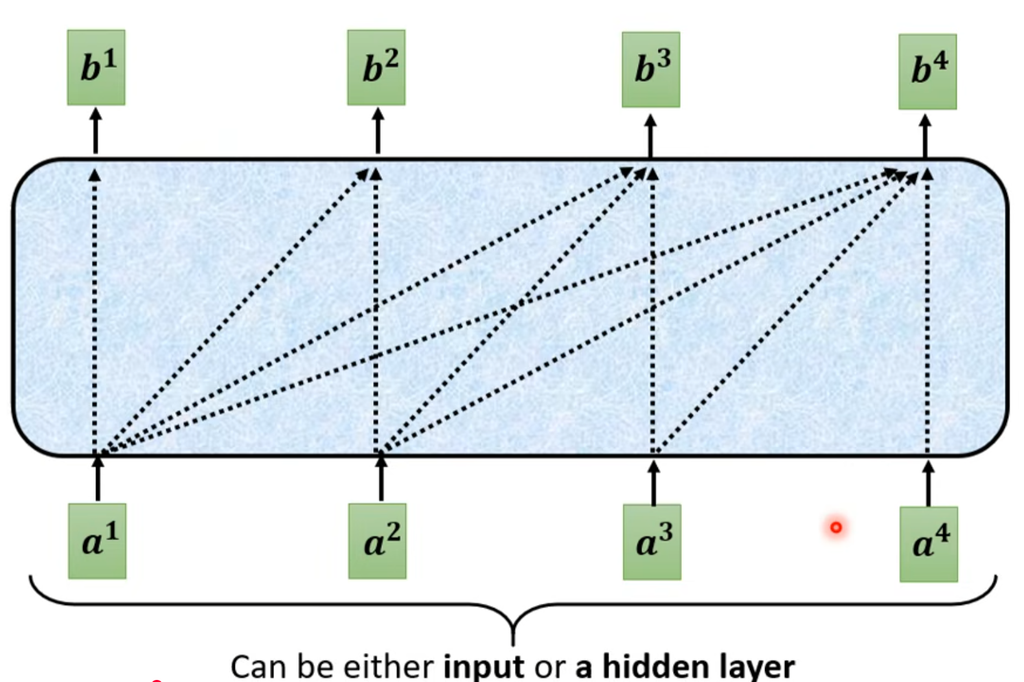
例如a1只能考虑a1,a2考虑a1和a2,a3考虑a1,a2和a3,依次类推
- b. 如何决定长度
对于输出的长度是不定的,所以我们要规定一个特殊符号作为end,用来结束输出
3.2 Non-Autoregressive
- a. 不同点
相对于Autoregressive,Non-Autoregressive不是一个一个的输出值,而是直接输入一串begin值,然后直接生成一个句子进行输出
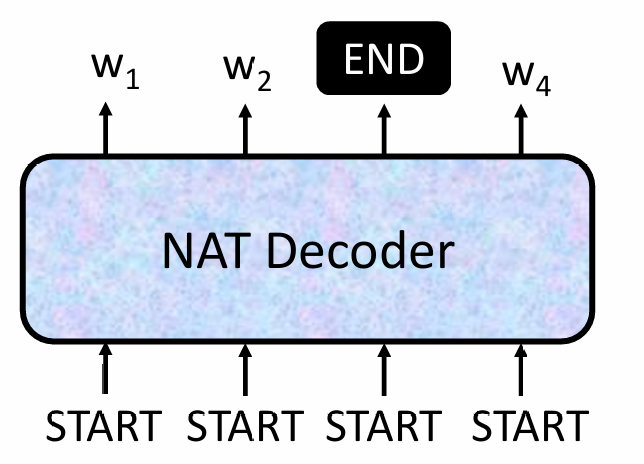
- b. 如何知道begin的数量
1.使用一个classifier决定begin数量
2.直接手动指定一个输出上限,看到哪里出现end特殊符号,end后的输出不做效
- c.好处
可以使输出的速度更快,而且可以控制长度
3.3 如何决定中间值
我们在刚才的Decoder的运行图中可以发现多出来了一块,这里我们来分析中间值是如何计算的
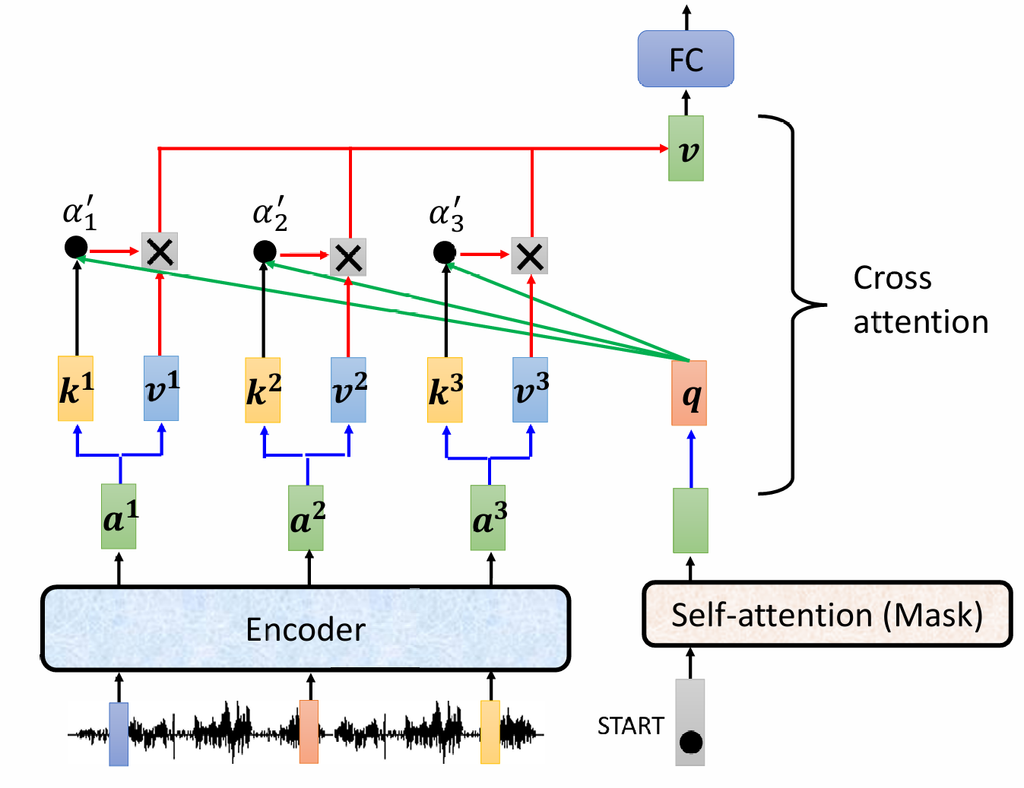
中间值的计算就是cross attention的过程,要注意到这里是有两个箭头的,意思就是与Encoder的输出有关系
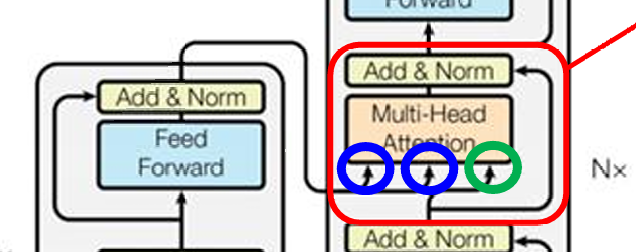
首先通过Decoder的Self-attention进行输出,输出一个q值,将q与Encoder的结果k计算,得出相关性分数,再与v相乘得出结果
最后再将结果交给FC处理,得到最终的结果
三. 如何Traning
- 1. 主要
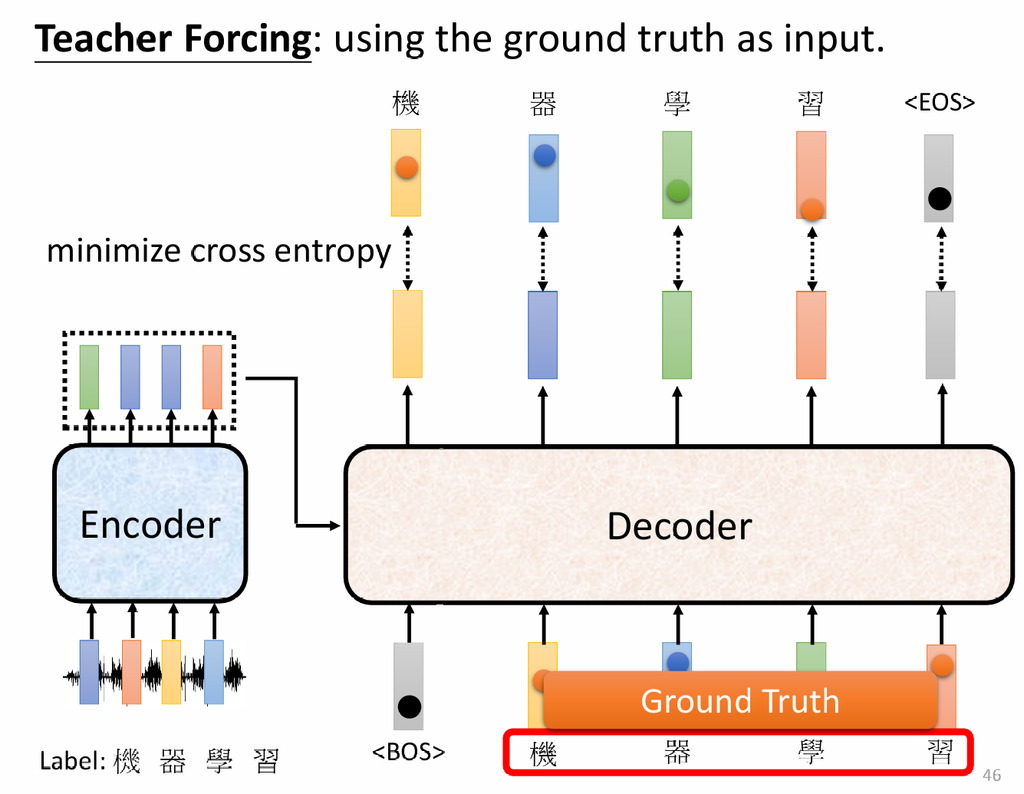
首先要使corss entropy最小,也就是当前预测的“下一个值”概率分布和真实答案的概率分布之间还差多远
并且在训练时要输入时要给出正确答案,也就是teacher forcing
- 2. Tips
这里还有几种可供使用的方法,有可能能派上作用
a. Copy Mechanism
不需要从头开始创造输出,多用于聊天机器人,做摘要,可以直接复制一些输入的值
b. Guided Attention
强制机器的attention有一个固定的样貌,例如解码TTS,可以让他的attention强制从左向右
c. Beam Serch
用于寻找分数最高的路径,一般用于有确定性答案,需要创造力很弱的模型,但是有时最完美的不一定是最好的,要慎用
- 3. 如何选择最好的训练结果
总结一下,训练结果看Cross Entropy,每个输出的正确性,最后的结果看BLEU Score,也就是整个句子之间的正确性
总结
到这里三种输入输出方式就已经学习完成了,真实太好了,感觉这两个周头脑都要爆炸了
评论(0)
暂无评论