
引言
当我们遇到一些过于平坦的或者过于崎岖的loss函数时,你是否想过能不能直接改变当前的位置,直接跳到正常的位置,这篇文章将给出一种方式,可以最大情况的避免这种情况
一. Changing Landscape
有时我们的loss函数一直在同一个地方停留,可能不是参数的问题,也有可能是input值的问题,如果x过于小,那么更新的w参数就会变化很小,所以会一直停留
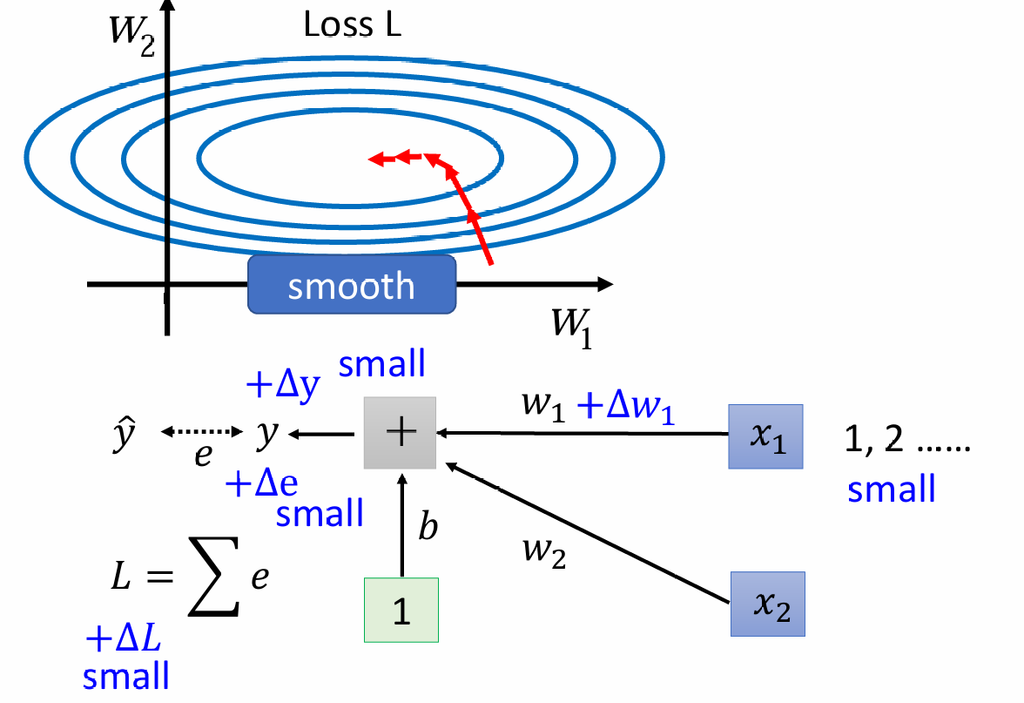
同样的,如果x过于大,w也有可能更新过快,导致loss函数不符合预期
因此,我们可以考虑在input值上思考问题,试着去改变x的值
二. Feature Normalization
- 1. 更新参数
首先我们算出x的平均值mean,再算出标准差standard deviation,再利用以下的公式更新输入值
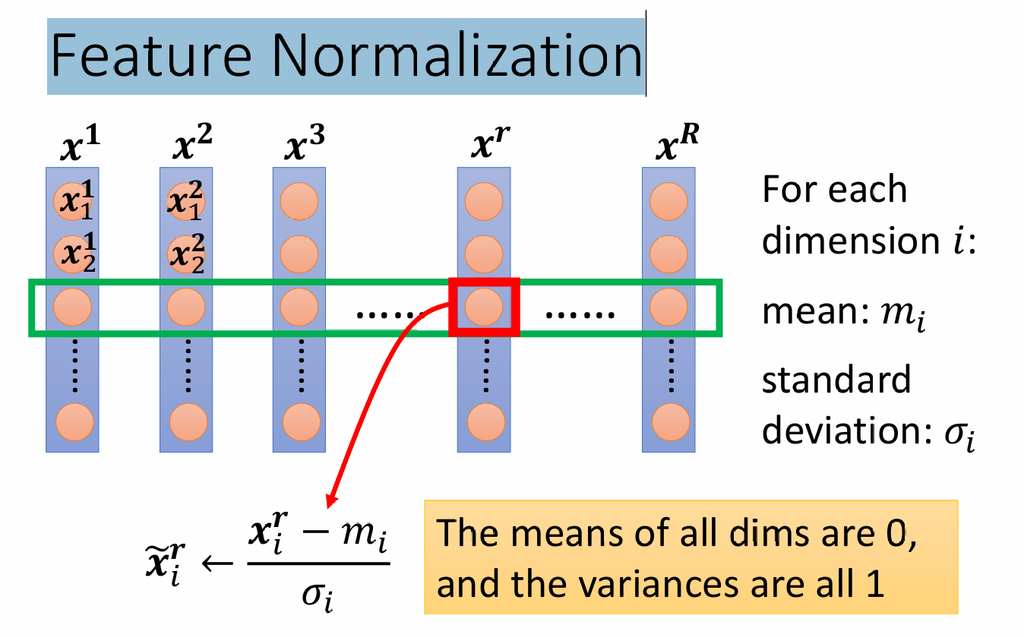
这里给出这里面参数的中文解释:
i :梯度
m:平均值
σ:标准差
这里给出标准差的计算公式:
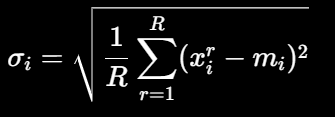
- 2. 更新的意义
这样可以使所有的x值平均数为0,标准差接近1,x表示的是与标准差的关系,数据之间原本的相对关系没有被破坏,只是尺度改变了
这时候每一个特征都处在相近的尺度上,模型更容易训练,梯度下降通常也会更稳定、更快
- 3. 代入模型
得到结果后就将数据代入参数后进行计算,并且更新参数
不同于之前的是,一般得出新的预测值后就用预测值计算当前梯度,但是这里我们可以再对预测值进行normalization的处理,再代入计算出新的参数,如图
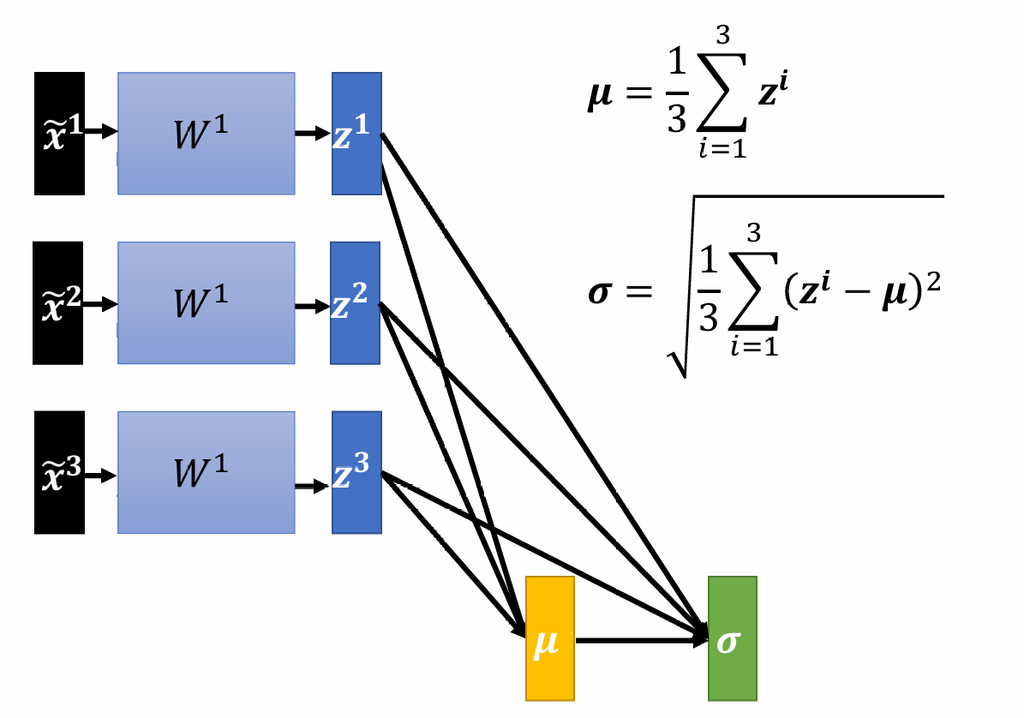
对于这个例子,z是沿着维度统一同一个future的数据
- 4. 总结
总的来说,我们可以将更新参数的过程看成一个大的network,因为有更多的过程,要更新更多的值,如图所示
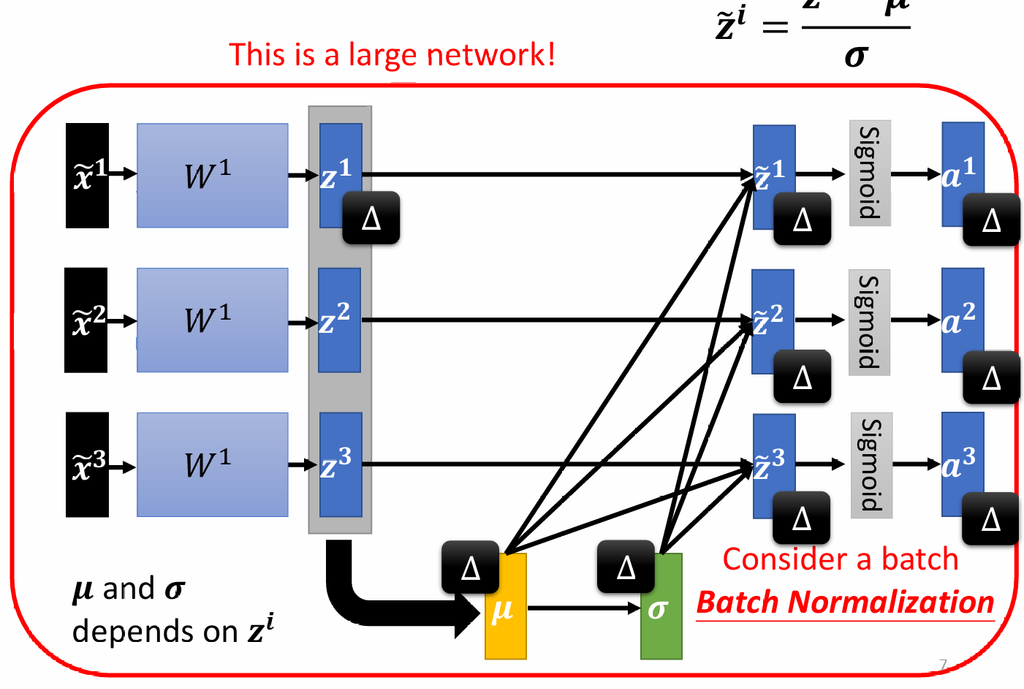
虽然这样已经可以让optimization更顺利了,但是因为这个network过于大了,所以我们可以结合之前学过的batch,将这些数据拆成几个batch再计算,这也就是本章的重点内容:Batch Normalization
三. Batch Normalization
- 1. 决定batch大小
这里的batch size不能太小,因为要计算平均值和标准差,所以batch size至少要达到一定的大小
- 2. 再次更新预测值
在上一节中我们对输出的预测值z再次进行了normalization,但是这还不够,为了让模型更好的计算,我们可以在此基础上把它调整成自己真正需要的状态
注意,这里的γ决定的是缩放,β决定的是移动多少,并且这两个值就跟learning rate一样是动态的,也要根据情况改变,让神经网络自己学习“最合适的尺度和中心位置”
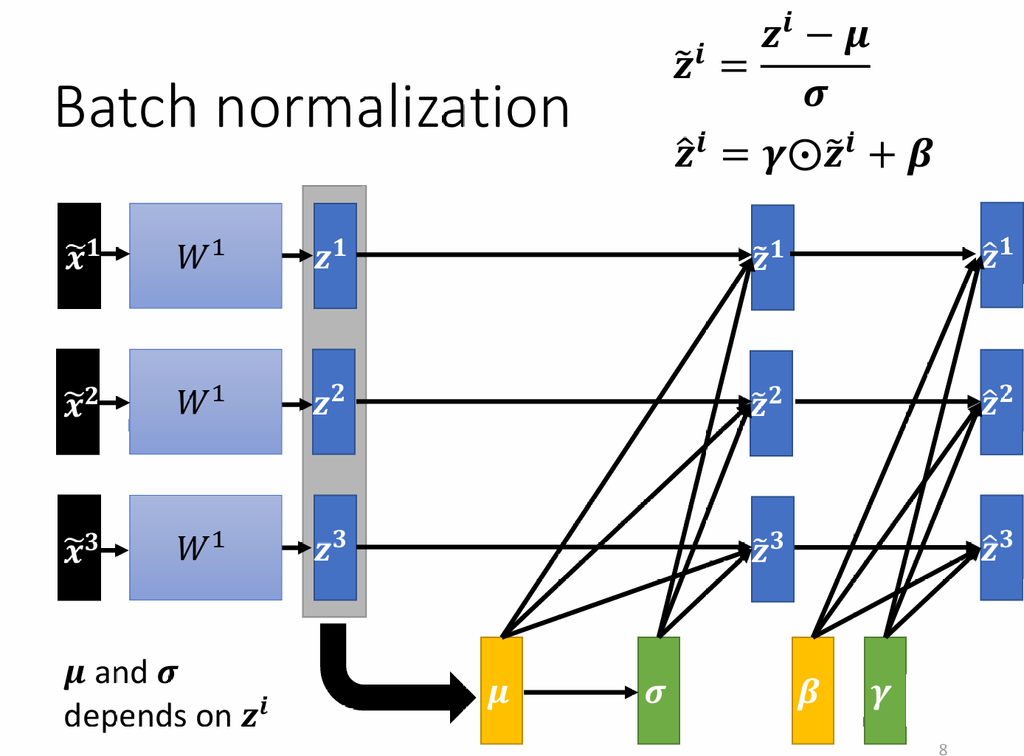
上图就是Batch Normalization的全过程
- 3. 特殊情况
当我们真正的在工作时,如果batch没有达到size大小时,该如何计算,是等待资料补齐到size大小再计算吗,这无疑是不行的,这里我们给出一种方式
当我们在计算所有的batch时,我们同时也会计算所有batch的平均值mean和标准差standard deviation,当最后一个batch size大小不足时,就会直接调用这两个值进行辅助计算
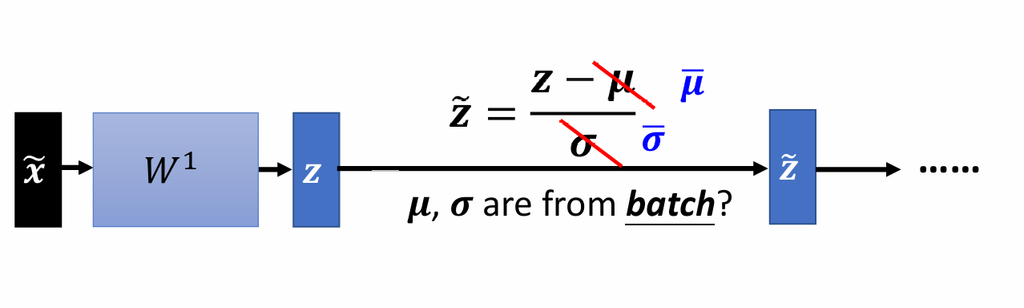
- 4. 测试例子
这里给出几个例子,大家可以进行对比使用了Batch Normalization的结果和没有用的结果
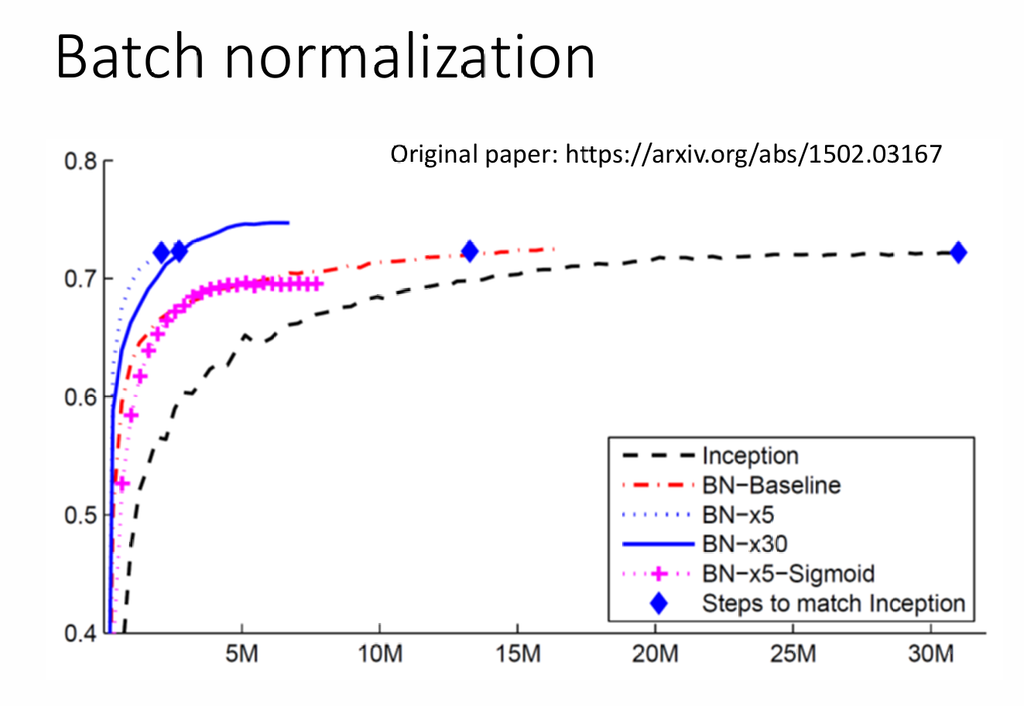
四. 总结
Batch Normalization 会在训练过程中,对一个 mini-batch 中同一特征维度的中间激活值进行标准化,再通过可学习参数 γ 和 β 对其进行缩放和平移,从而使各层输入的尺度更加稳定,同时保留网络学习合适数据分布的能力
其他
其实对于Batch Normalization为什么对优化有帮助有很多的解释,但是我比较喜欢的是一种说法,这种优化方式就像是一种意外之喜,意外的就能对优化产生好处,很幸运不是吗
评论(0)
暂无评论