
引言
在之前的学习中,我们常常是通过输入一个向量输出一个值,但是在机器学习中,常常会出现输入多个向量,并且输出多个值的情况,这时候就要用到本章学习的内容
一. 输出
network的输出为向量集合,分为了这几种情况
- 1.1 长度相同
每个向量的向量长度相同
- 1.2 长度不同
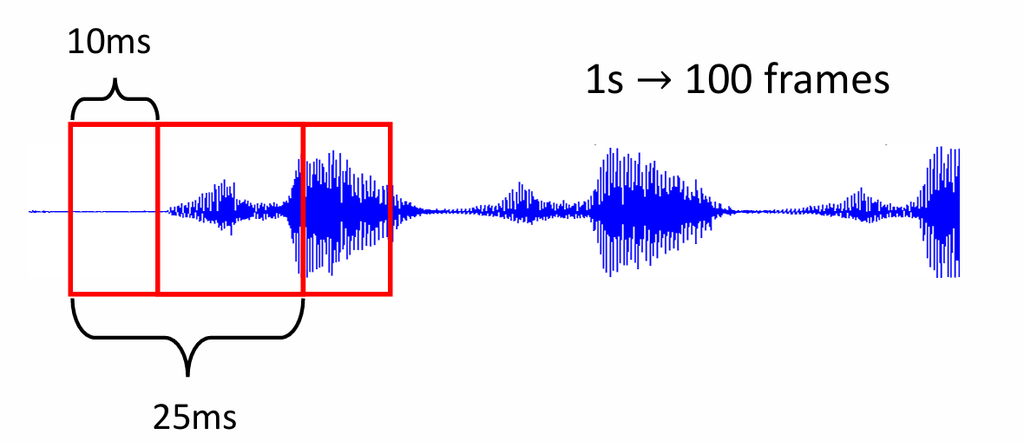
每个向量的向量长度都不同,例如输入一句话,声音讯号,一个图表
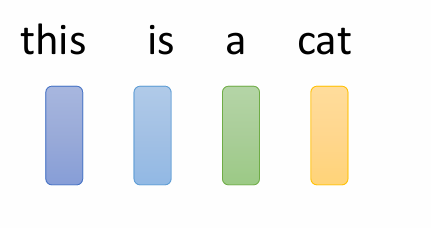
二. 输出
输出也分了三种情况,这里给出讲解
- 2.1 每个vector都有对应的输出label,输入与输出数量相同
- 2.2 只输出一个label|
- 2.3 不知道输出多少个label,由机器自己决定
本篇内容先解决第一种情况,输入与输出数量相同
三. Sequence Labeling
Sequence Labeling这种方式使用来解决输入与输出相同的情况
- 3.1 Fully-connected
通过FC的方式可以输出每一个向量对应的值
- 3.2 优化
但是FC是考虑的全部输入向量,再输出对应当前向量的值,但是这种方式太过耗时
因此我们采用window窗口的方式,将目标向量的前后几个向量圈进去,再考虑输出,可以节省时间和算力
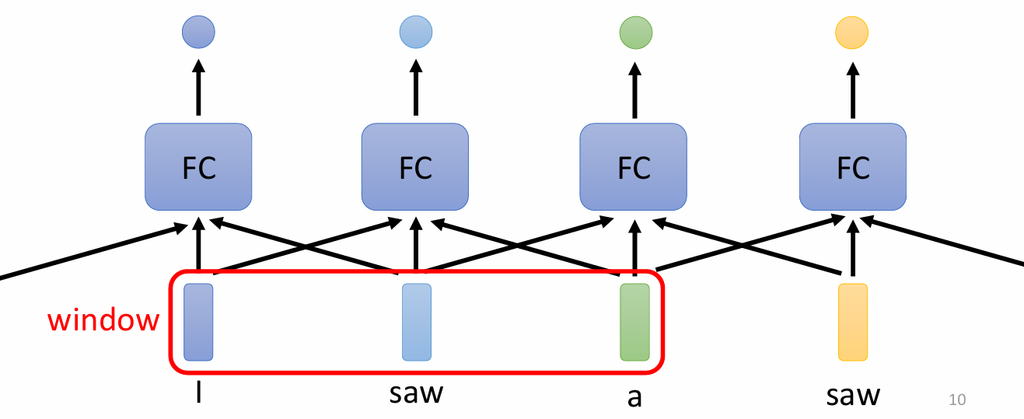
但是对于这种方式仍然存在弊端,因为窗口的大小是需要我们自己去指定的,并且也存在错误的情况,例如输出一个句子的单词词性,没有考虑全就可能会输出错误结果
因此我们采用了Self-attention进行优化
四. Self-attention
- 4.1 作用
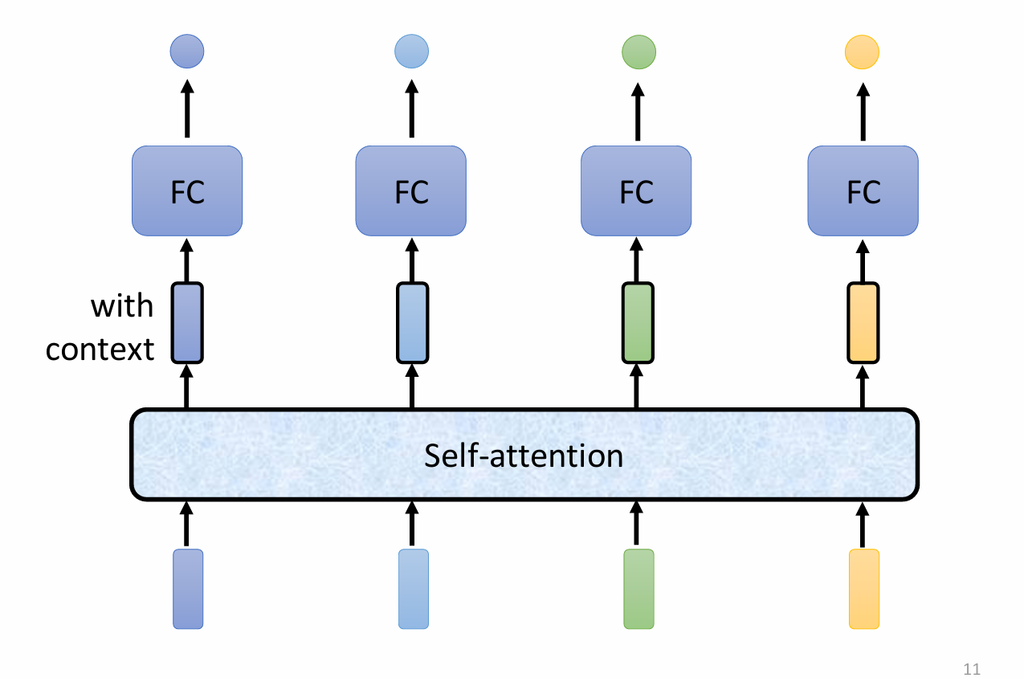
Self-Attention 使序列中每个输入向量在产生对应输出时,都能够参考序列中其他位置的信息,通常输入n个向量,就输出n个新的向量
- 4.2 使用方式
一般与FC混合使用,Self-Attention 负责提取上下文信息,得到新的表示 ,之后可以根据任务再送入全连接层等网络进行预测,如图
- 4.3 运作原理
a.输入的数据通常已经被表示为向量,例如 token embedding,或者前一层网络输出的特征向量
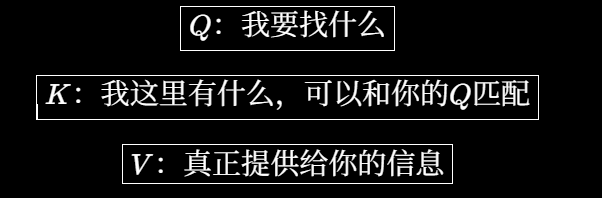
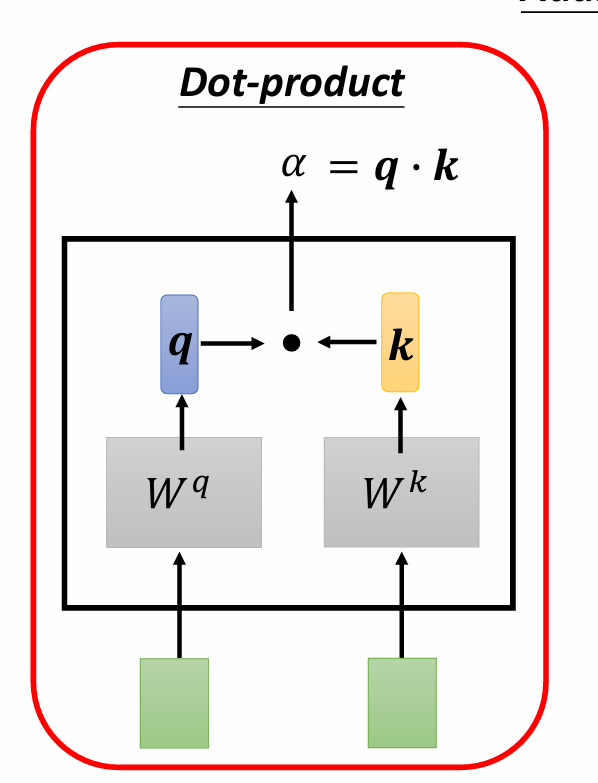
b.分别通过特定值算出两个向量q和k,q用于查询需要的向量,k(Key)用于和 q 进行匹配q 与 k 的点积决定两个位置之间的相关程度,α用于表达最终的结果,关系也可以表示成这样:
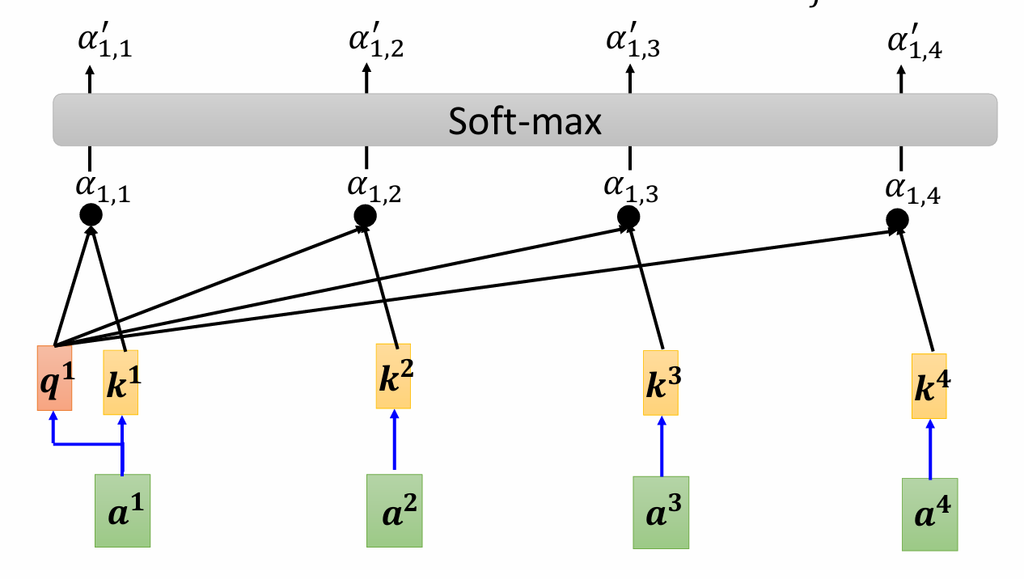
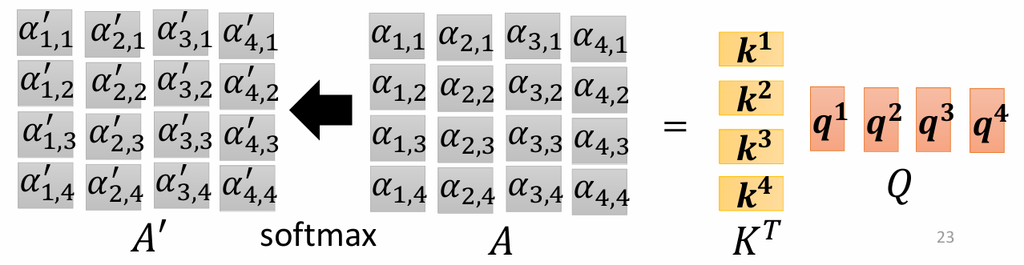
c.分别计算 q 和各个 k 的 attention score,再通过 Softmax 将这些 score 归一化为 attention weight
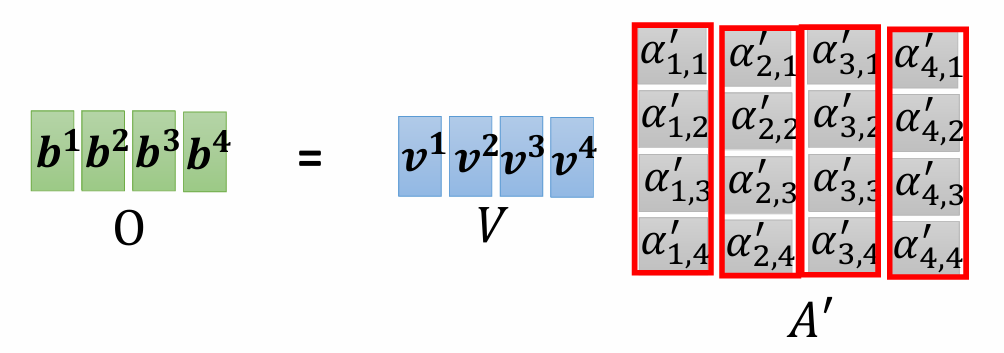
d.同时,再计算出v,v起到了提供内容的作用,再将α与v相乘相加得到最后的结果
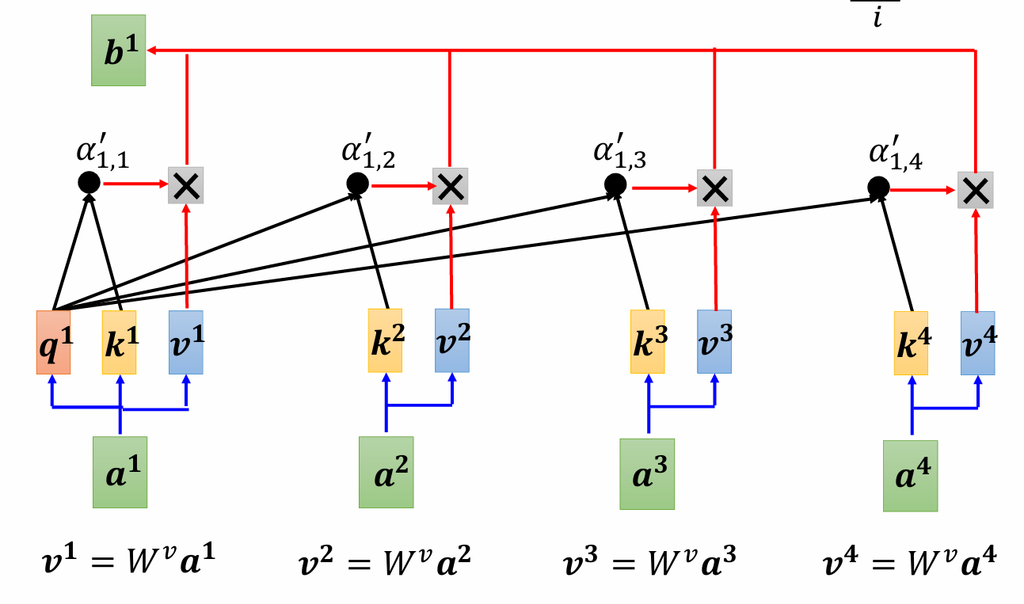
e.为了便于理解,可以分别计算每个 ,实际实现时通常将所有向量组成矩阵,通过矩阵运算一次并行计算
- 4.4 更好的理解
可以将k,q,v的结果,甚至a的结果都看作一个大矩阵,他们的计算就如同矩阵计算,如下图所示
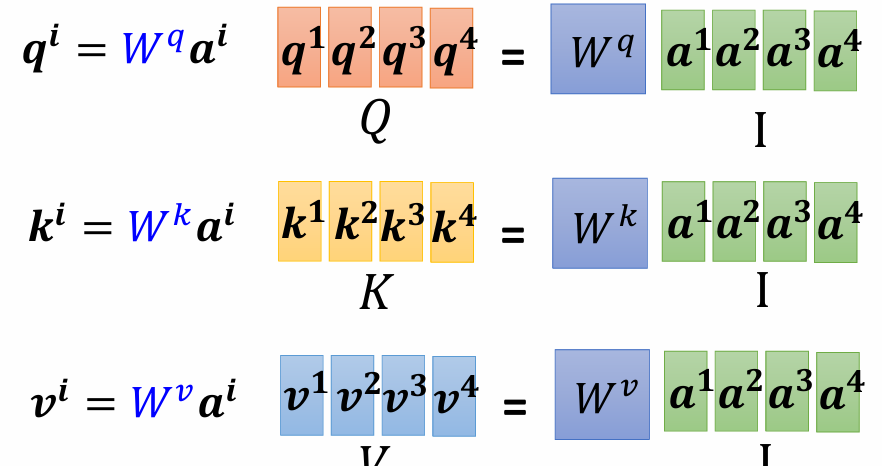
五. Multi-head Self-attention
对于Self-attention,还可以进行一定程度的优化
- 5.1 第一步
将q,k,v分成n个head,可以产生不同的相关性
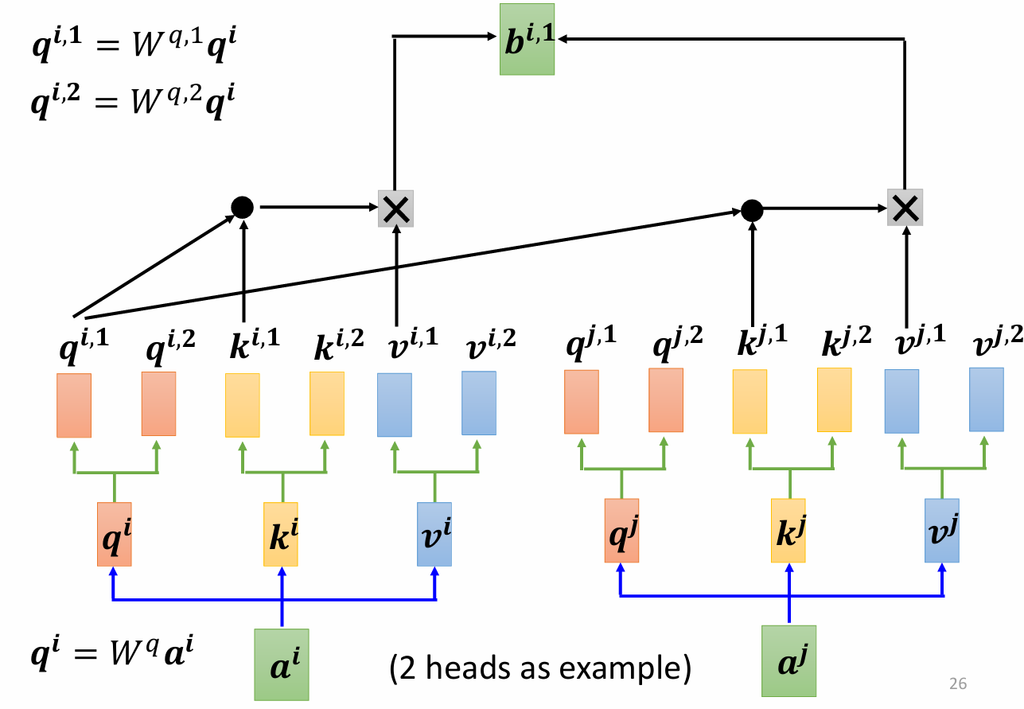
- 5.2 第二步
再对不同的head分别计算得score,再通过一个矩阵将score拼起来
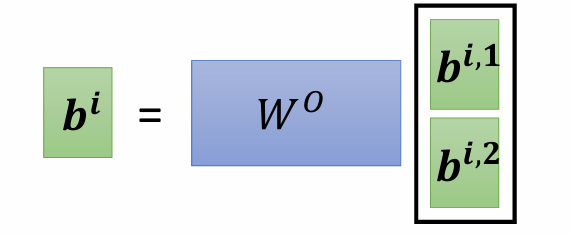
六. 缺陷
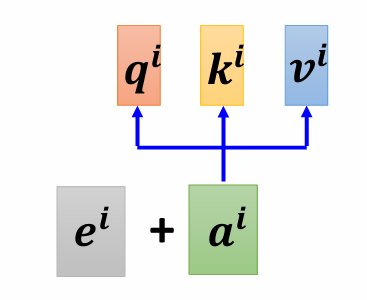
要注意的是,在Self-attention中,所有的结果都是同时计算出来的,因此计算中是不存在位置的咨询的,对于一些需要位置咨询的数据,我们可以认为的为数据增加一个关于位置咨询的向量e,加在α中
七. Self-attention的具体应用
- 7.1 Self-attention for Speech
对于一些声音讯号的识别,我们可以运用到Self-attention,但是声音讯号一般是很长的,并且隔得很远的讯号关联性不强,所以我们同样可以将声音讯号切成小片段进行分析,这就是Truncated Self-attention
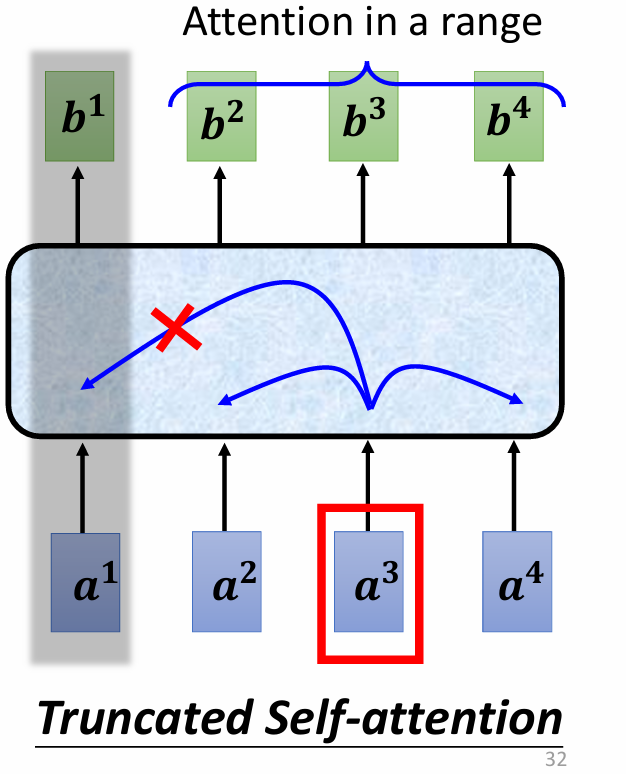
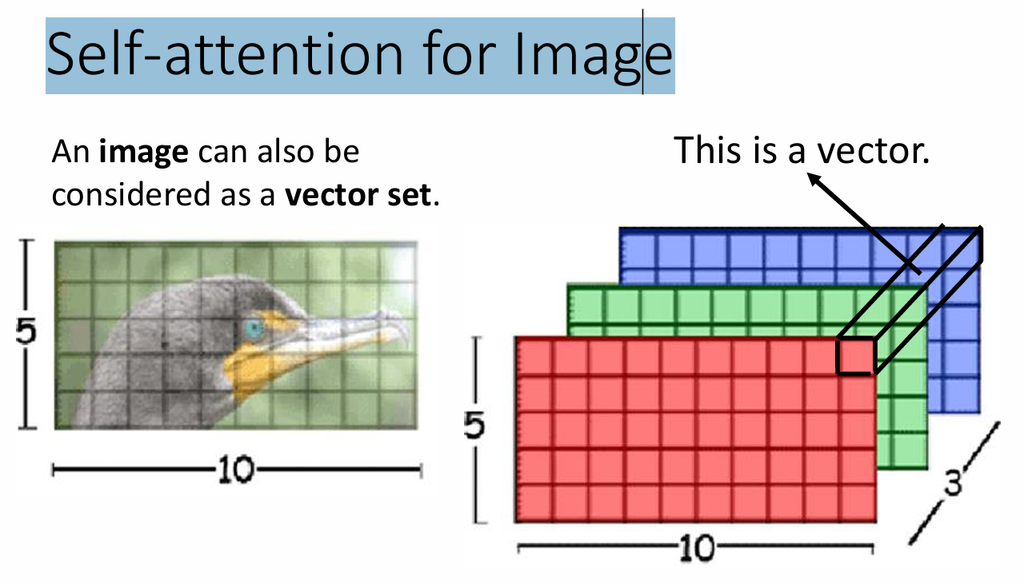
- 7.2 Self-attention for Image
对于图像来说,我们也可以将它看作多个向量的集合
八. Self-attention v.s. CNN
在上文中我们说到,影像的识别也可以用Self-attention,这里我们对比一下同样可以用于影像识别的CNN
- 8.1. 区别
a.CNN是简化版的Self-attention,Self-attention包括CNN
b.处理数据的能力不同
- 8.2 如何选择
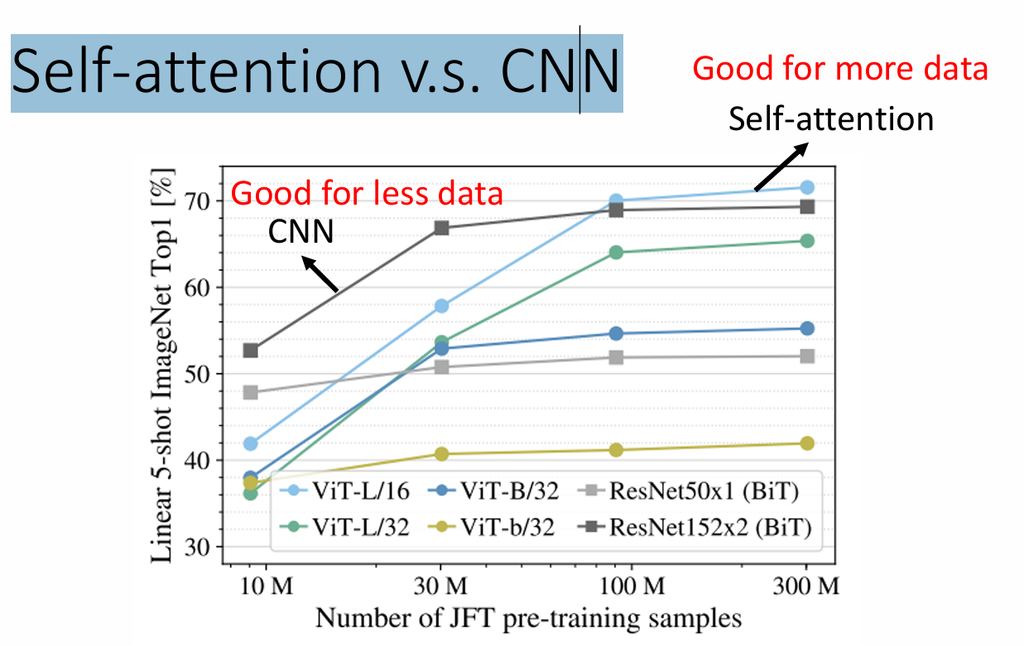
要基于数据的复杂性进行选择,复杂的data可以选择Self-attention,不是特别复杂的选择CNN,因为CNN的弹性更小,通过下图可以看出
结尾
这篇文章到这里就结束了,可喜可贺可喜可贺
评论(0)
暂无评论