
引言
从今天开始我将把学习机器学习的内容分享在这上面,如果有错还有望指正,毕竟刚刚才开始学习
一.模型类型
机器学习是在选定模型后,用数据训练它,让模型学会合适的参数或规律,常见机器学习任务包括回归、分类、结构化预测/生成等
- 1. regression
回归根据输入预测一个或多个连续数值(可以是标量,也可以是向量)
预测连续数值,例如根据面积和地段预测房价
- 2. classification
把输入判定为一个或多个预先定义的类别
如“这封邮件是垃圾邮件还是正常邮件”
类似于围棋中的阿尔法狗,就相当于是一个 classification,就是将多种下法看成了多种类别,然后判定一个类别
- 3. structured learning
也就是机器创造,让机器按训练数据学到的规律组合出新内容
二. 如何寻找符合的函数
- 1. Function with Unknown Parameters
基于领域知识,先选择合适的特征和模型形式,再利用训练数据学习模型中的未知参数
列如 y = wx + b
这里的w和b就是参数
- 2. Define Loss from Training Data
通过loss来判断函数的好坏,回归中常用 MAE 和 MSE,具体损失函数取决于任务
MAE 是预测值与真实值的绝对误差的平均值;MSE 是预测值与真实值的平方误差的平均值
注意:loss 小表示它在训练数据上表现好,不一定代表面对新数据也一定好。
- 3. Optimization
这一步是最优化,在已经选定模型形式后,找到合适的参数,使 loss 尽量小,一般是通过计算微分(梯度),一元函数中导数是切线斜率,多参数情况下,梯度由各参数的偏导数组成,指向 loss 增长最快的方向

这里的L相当于函数,w就是未知数
用学习率 η 乘上梯度,决定每次参数更新的步长,η代表的是学习速率,可以自己设置大小,可以控制学习的快慢,也就是hyperparameters
注意:学习率太小,训练很慢;太大,可能错过最低点,甚至无法收敛

不仅如此,还要根据loss来改变参数,如下:
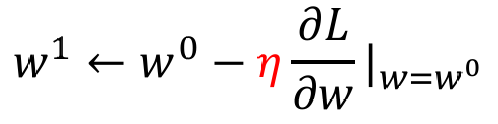
这里的正负号是由微分的正负,也就是梯度(gradient)决定的,改变参数要往loss变小的方向走
当然,b也要更新
停止最优化有两种方式:
1.梯度范数足够小
2.次数(epoch)达到了就自动停止
三.Piecewise Linear
- 1. 介绍
在之前的二部分我们计算的是linear model(线性模型),单个未知数时为一根直线,多个未知数是为一个平面但是Piecewise Linear可以是一个折线,或者多维时,区域连接处可以有“折点”
- 2. 怎么写
对于这类函数,我们相当于在函数的转折点算一根新的直线,再将这几根直线拼在一起,如图,红色函数就是目标函数,利用常数+蓝色线段的总和就可以得到最终的函数

Piecewise Linear相当于把几根直线拼在一起,但是有一些函数并不完全是函数,我们可以用曲线去逼近它,如图:

图中是将hard sigmoid 转化成 soft sigmoid的公式,这里的c决定函数高度,b决定左右移动,w决定斜率大小
将所有函数转化或者不转化后,多个 sigmoid 的加权和可逼近许多平滑非线性函数(piecewise linear),并且与linear model结合后,可以更准确
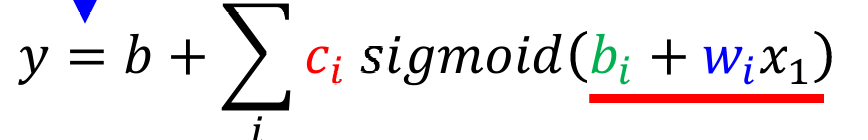

对于这个公式,可以这样理解
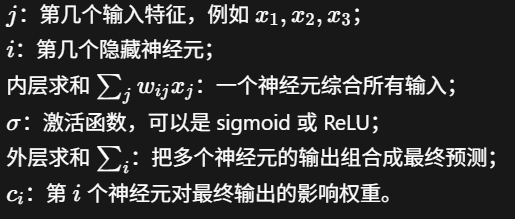
里面那一层的求和相当于是把多种特征值暗转权重相加,针对于有多种特征值的情况,而外面的那一层相当于把几个函数拼起来
- 3. loss
这里的loss要包含四个未知参数,记作θ = b c (b) w,注意这里的两个b是不一样的

这里相当于在计算平均误差
- 4. Optimization
首先是随机选θ,也就是随机取未知函数的值,然后计算gradient(梯度),也就是微分的总和,如图

同样的,毎算完一次,可以通过微分的结果(梯度)得到下一次θ的值,也就是更新参数,以减少loss
这里的η就是学习速率,跟之前的是一样的
为了让Optimization更顺利,我们可以将N个样本分成几个batch,通过batch1算出θ0,再通过gredient算出θ1,将θ1代进batch2计算,循环下去,可以更好地得到更小的loss,再从中找到最小loss对应的θ,如图

这里再补充一个epoch的概念,1 epoch = 将所有的batch看一遍,而看一次batch就相当于是一次update
- 5. Sigmoid → ReLU
如果输入长期不小于0,可以将Sigmoid换为ReLU,因为ReLU可以更好的返回梯度的大小,训练更快

对于ReLU来说,两个 ReLU 可以做出“先上升、后保持平坦”的粗略形状,用来近似 sigmoid 的一部分;若想更精确地拟合平滑 sigmoid,通常需要更多个 ReLU,这样才能表示出转折,例如

- 6. 反向传播(backpropagation)
通过不断的更新参数,以减少loss方式
这里相当于通过右侧的函数算出loss,再通过loss改变参数,不断循环,优化loss

总结
这篇博客估计是我写的最累的一次了,因为上完课本来不懂的就很多,通过不断的与ai交流才得到了这篇文章,也是收获满满了
评论(0)
暂无评论