
引言
这一章将讲解关于Diffusion Model背后的数学原理,首先我们从同样是生成模型的VAE开始讲起
一. VAE
- 1. 运行流程
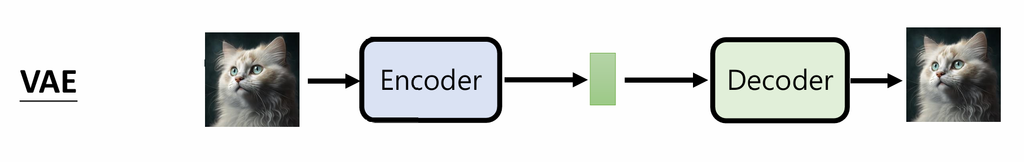
同样的,VAE也是生成模型,但是不同的是,它更多的是利用到Encoder和Decoder的作用进行生成
核心思想是先把图片压缩成一个隐藏空间(latent space)的表示,再从这个表示恢复图片
Encoder负责生成图片的latent vector z(隐藏特征),Decoder再根据这个z生成图片
例如生成一只猫的图片,z就可以表示为它的毛发,颜色,眼睛等等
流程图如下:
- 2. 与Diffusion Model对比
a. 生成图片方式完全不同
b. VAE生成的速度更快,Diffusion Model生成更慢,但是生成图片质量非常高
c. Encoder对于VAE影响很大,直接决定了生成图片的质量
二. 训练流程(总体)
- 1. 训练predictor过程
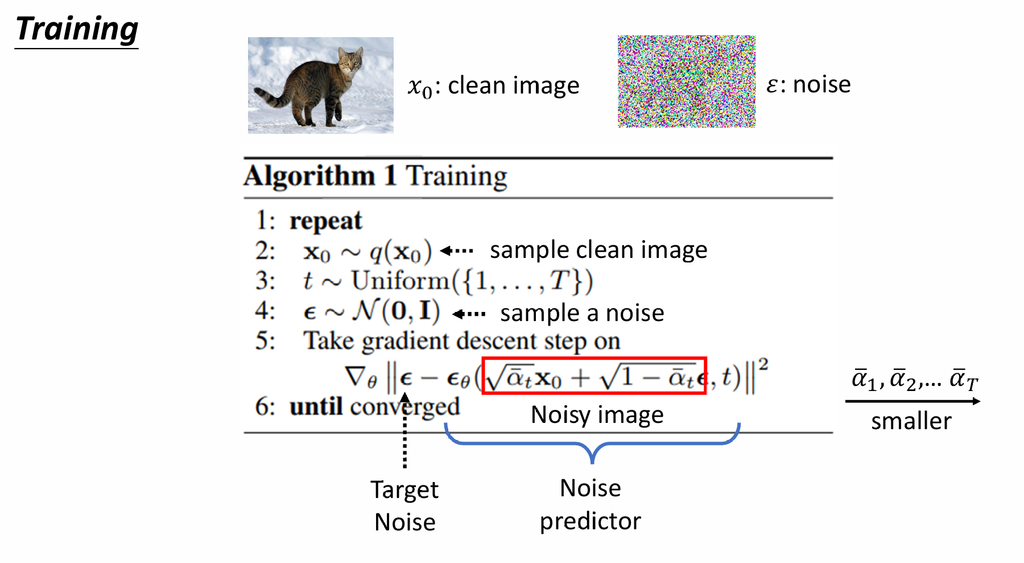
这里是全部流程的总结图,接下来我将一步一步为你拆解
a. 随机一个样本sample,也就是随机找一张清晰的照片
b. 随机找到一个时间步
c. 随机设定一个噪声
d. 进行公式的计算,更新参数
e. 不断重复这个过程训练模型
这里来解释一下这个公式:
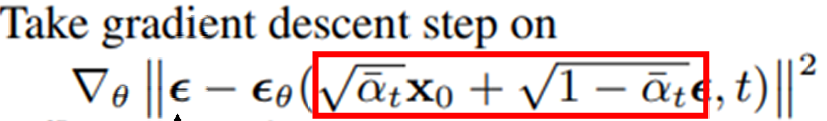
这个公式是用于更新参数的
α:控制现在有多少原图、多少噪声

随机生成的高斯噪声
x:原始图片
因此小括号里计算的就是要保留多少原图片的特征,
loss:
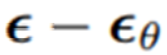
Loss 对神经网络参数的梯度:

- 2. Diffusion Model运行流程
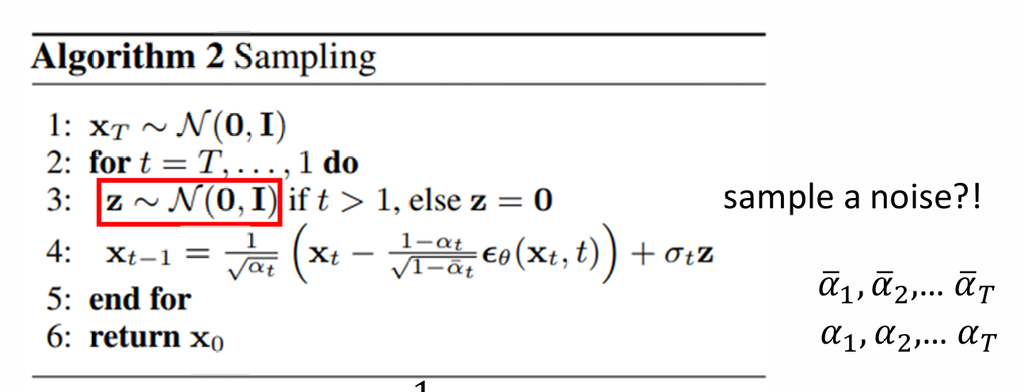
这张图讲的是 Diffusion Model 在推理/采样阶段,怎样从纯噪声一步一步生成图片
接下来我将逐行讲解
第一行:
先生成一张纯噪声图
第二行:
表示从T到1依次降噪,逐步去掉图片里的噪声
第三行:
挑选一个随机噪声,只要t > 0,为什么t = 0时不需要,因为t = 0时就是最终结果了不需要额外的随机噪声
第四行:
这个过程是在去噪,前半段就是通过参数去噪,最后一位指的是添加一个随机噪声,以便于图片的去噪
为什么要加随机噪声:
从模型所定义的概率分布中进行采样,增加模型的随机性可以使结果更好
三. 数学原理
- 1. Maximum Likelihood Estimation
这一步的意思就是要将训练出的图像范围与真实的图像范围相似度高,如图所示
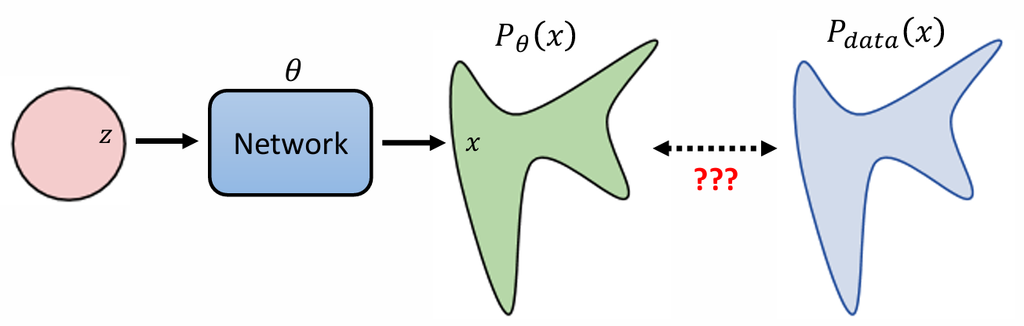
这里的Pθ就是训练结果,P data就是真实数据,目的就是让他们相似
如何让他们相似度变高呢,就是通过调整参数θ实现,这里给出通过算最大拟然算出最合适θ的方法
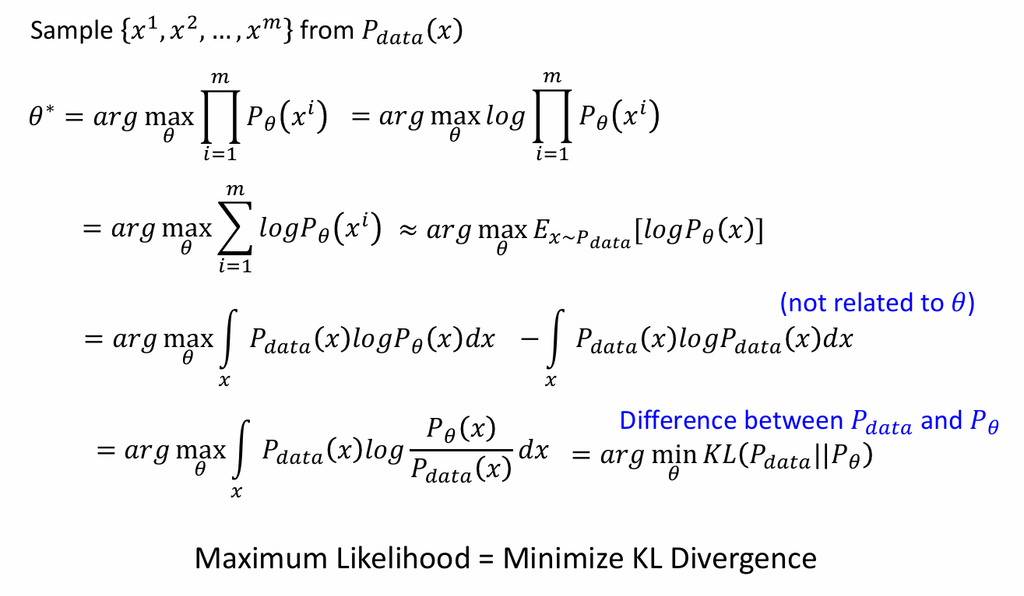
这里相当于随机挑选样本,计算Pθ与P data之间的差异值,也就是相当于在算KL散度,再将所有样本的结果相乘
但是直接计算很困难,假设训练样本独立同分布,整个训练集的似然是各样本似然的乘积,取对数后,乘积变为求和;由于对数函数严格单调递增,最优参数不变
最后通过arg最大拟然数选出能使结果最大的θ得到最终的参数θ
相当于转化为求它的最小的KL散度
- 2. Lower bound of log P(x)
首先我们要算每一步生成对应图的概率相乘,也就是跟上方的算式相似
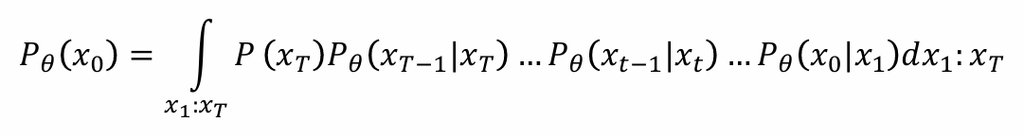
由于直接计算和优化数据的边缘对数似然涉及难以处理的高维积分,我们引入已知的前向分布 ,构造对数似然的下界 ELBO,并通过最大化这个下界训练模型
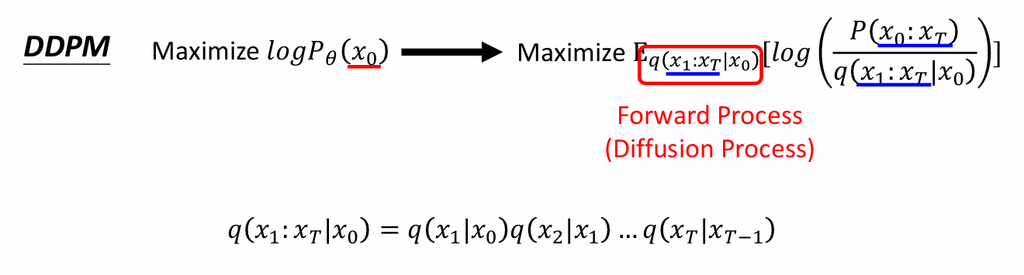
接下来我们再逐步解释一下里面的式子,首先解释这个式子
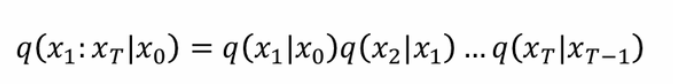
先分开进行讲解,先看一项
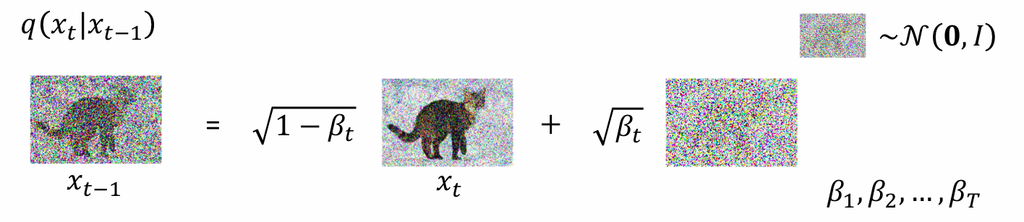
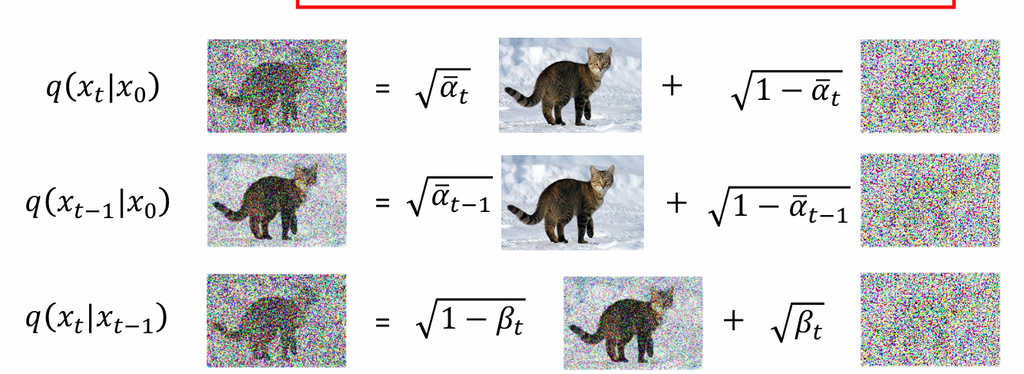
这里的β是我们自定义的参数,用于控制噪声的多少,而一次噪声图的合成就是这样的,接下来我们看多次合成的式子
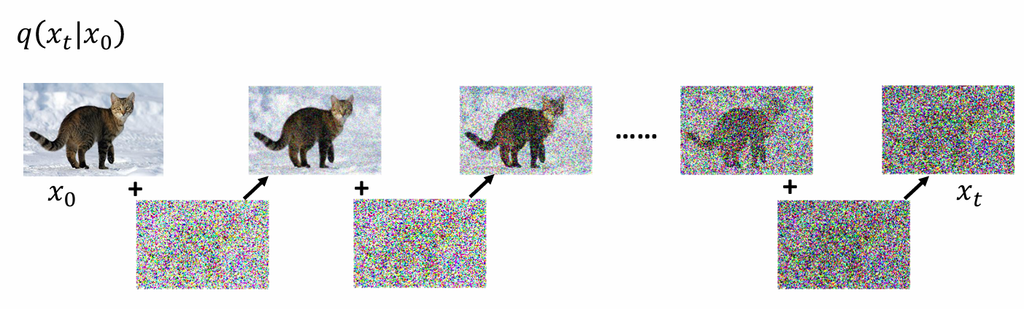
我们可以试着把上一次的式子代入进下一次式子中,如图所示:
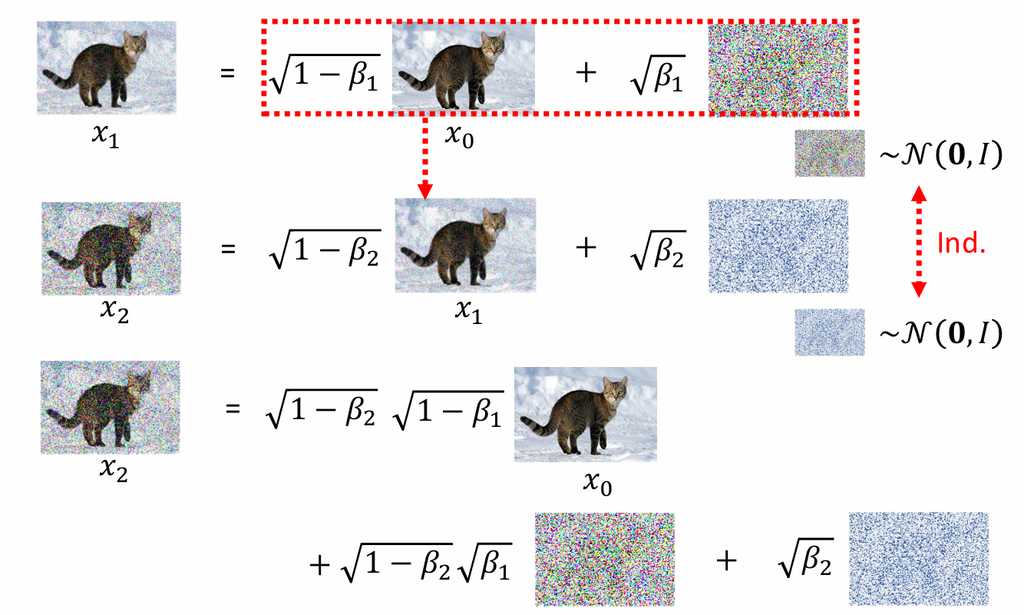
这里我们可以注意到随机噪声也分了两次进行加入,我们可以进行合并,变成一次随机噪声的加入,如图:
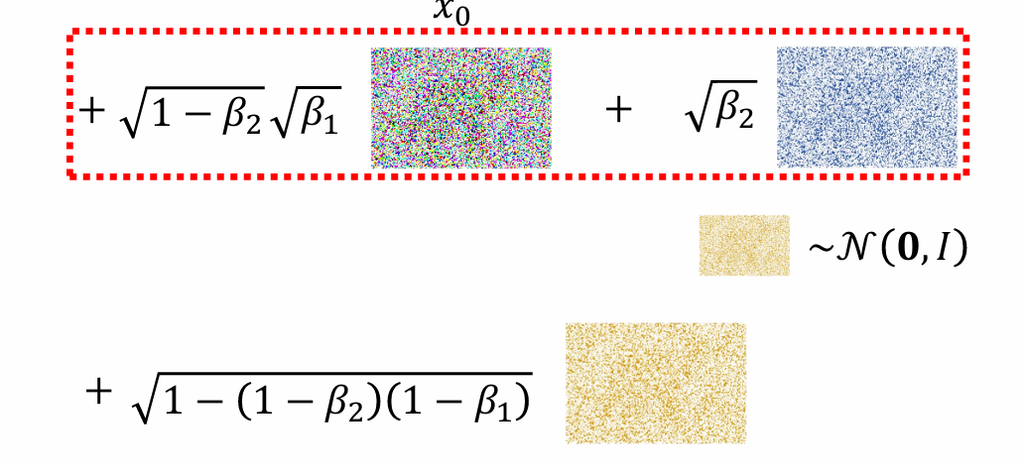
通过这样的计算,我们就可以直接计算随机时间步的对应噪声图,而不是一次一次的推演,同时再将α = 1 – β,如图所示:
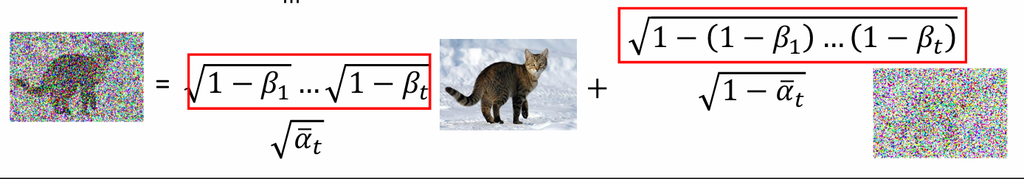
然后我们通过这个式子进行代入计算,再进行一系列的化简可以将log P(x)进行最终的化简,这样就可以进行计算了
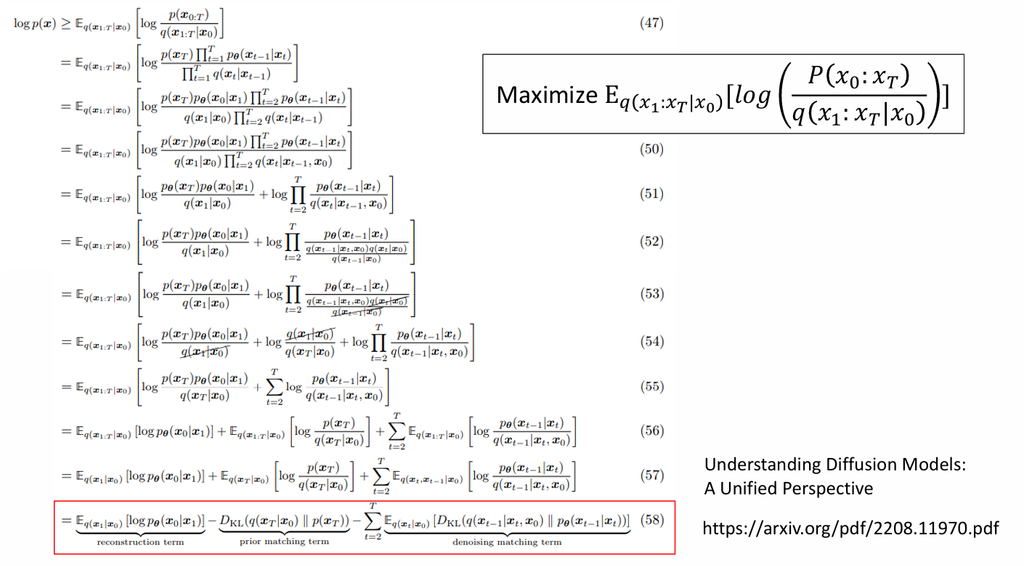
通过上述的计算可以得到最后的式子是这样的:
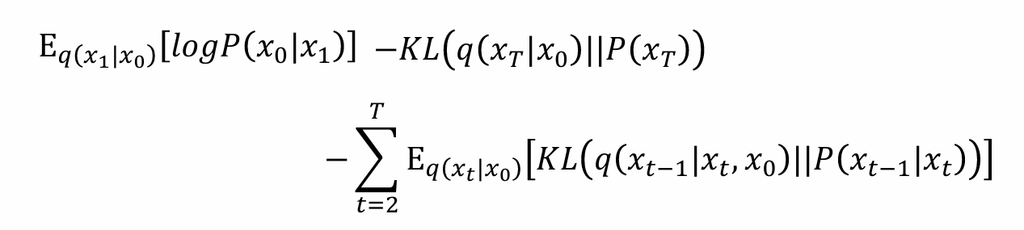
- 3. 计算拆分
先看前两项,第一项(重建项)关注的是最后一步,能不能成功从x1变为x0的真实图,第二项(去噪匹配项)是保证前向扩散到最后是标准的高斯噪声
当前向噪声日程和终点先验固定时,先验匹配项对 θ 是常数,可以在优化 θ 时忽略,重建项和去噪匹配项都依赖网络;下面先分析 t >= 2 的去噪匹配项
首先看括号类的部分,计算的是预测噪声和根据原图计算噪声的差异,目的是让它们的差距尽量为0,q项是利用真实原图 和已知加噪规则算出来的“标准答案去噪分布”,而P项是根据xt预测算出的去噪分布
接下来我们把q项拆开
这里我们再根据贝叶斯公式可以把它化简成这个式子:
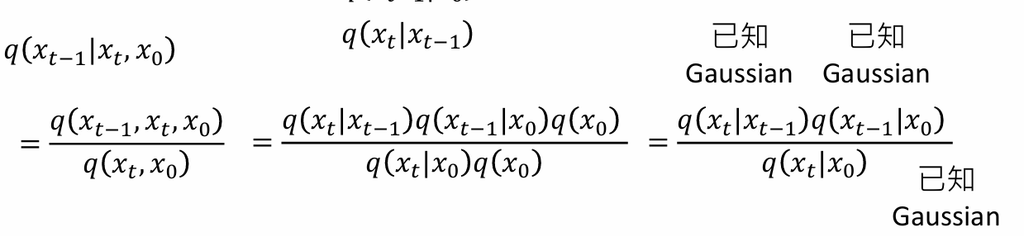
又因为这三个式子的Gaussian都是已知的,再代入进行一系列的化简可以得到结果
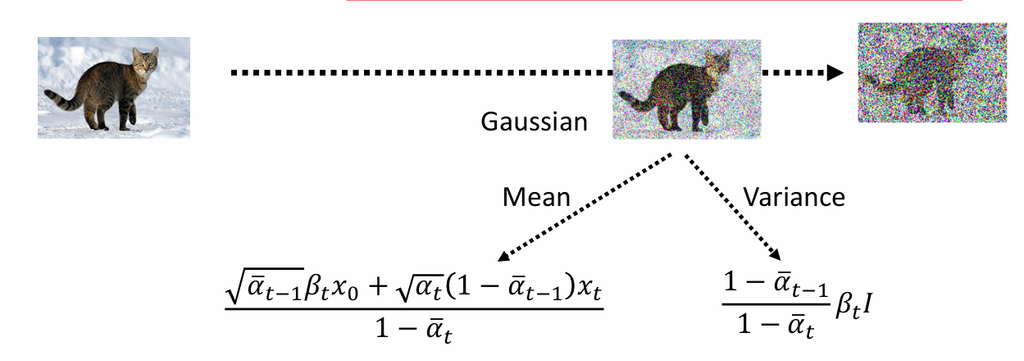
而这里面的所有参数都是已知的,所以我们计算两者的差就可以根据它们的平均值和标准差进行计算
但我们可以推出预测项P项的标准差是不动的,但是平均值是在变化的,所以我们要尽量让它的平均值接近q项的平均值
这里给出一张图表示该如何比较
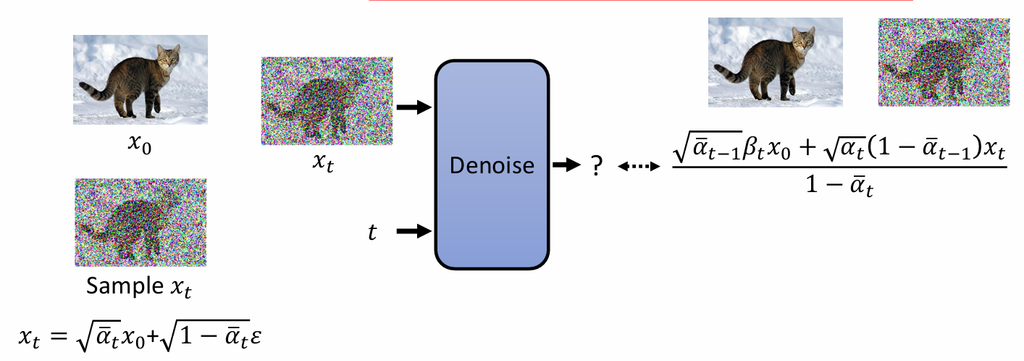
这里相当于随机抽选一个sample,如果网络直接预测反向分布的均值,就让预测均值接近真实后验均值。采用噪声预测参数化后,则让网络预测的噪声接近训练时加入的噪声,再用预测噪声计算反向分布的均值
而Xt是可以通过α表示的,而在生成图的过程中,x0是未知的,我们将x0进行替换,得到以下的式子:
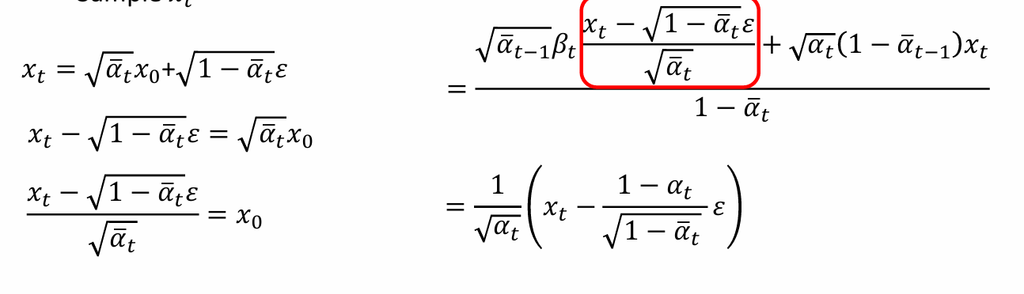
最后我们可以发现,我们实际需要network predictor的地方就是ε,也就是模型预测噪声
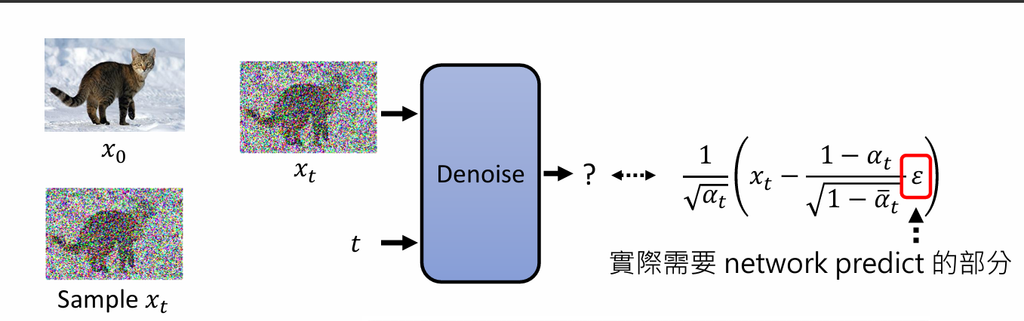
当我们化简成这个式子时,我们再回看Diffusion Model的运行流程,可以发现几乎是相同的:
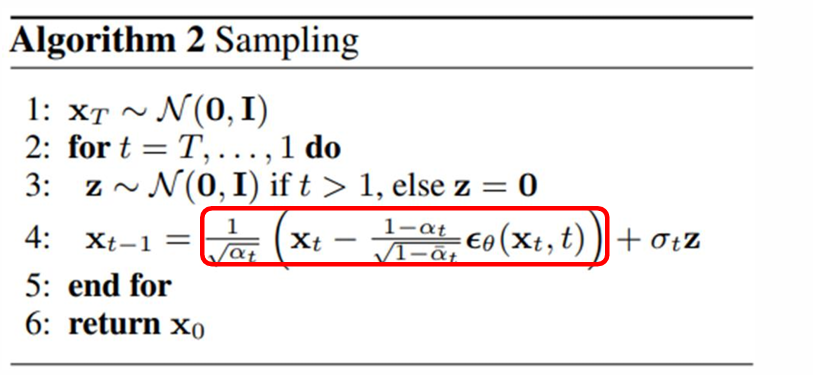
但是这里还多了一项,这一项是随机噪声,那么为什么我们不直接取平均值,而还要再随机加入一个噪声呢,接下来将进行一定的解释
- 4. 为什么要加入随机噪声
首先我先举一个例子,例如让机器生成一篇文章,如果它不加入随机性,就可能会一直生成重复的几句话,导致文章错误:
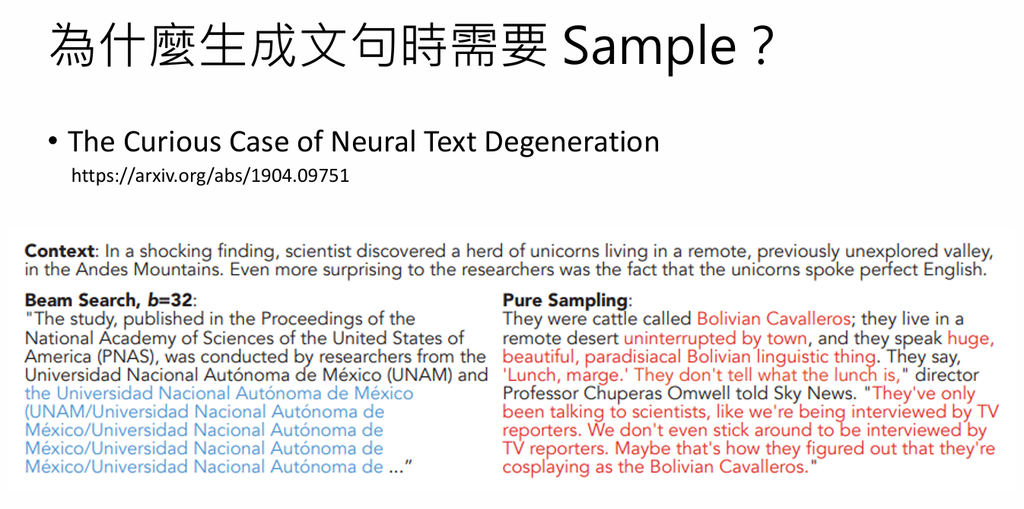
同样的,对于图像生成也是一样的,如果不加入随机性,生成的结果可能会很差,如图所示,上面是加入了随机性生成的图片,下方是没有加入随机性生成的图片:
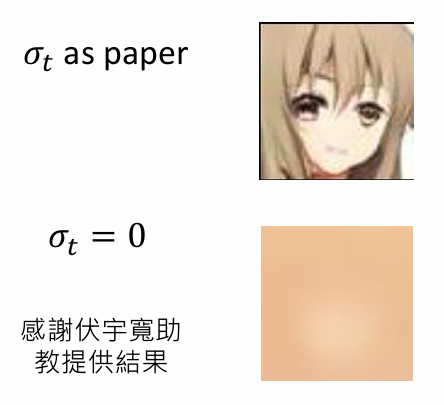
因此我们可以得出一个结论,机率最大(最完美)的未必是最适合的,当然这句话也可以用在生活里
- 5. 解决随机性错误
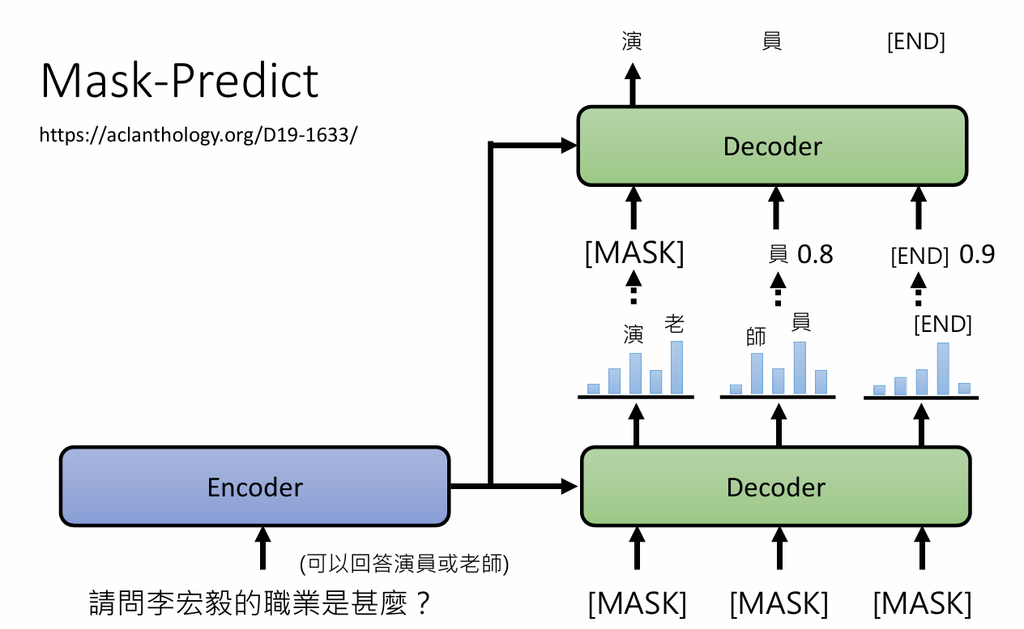
有时会遇到机率相差不大的问题,我们可以采用mask-predict的方法,就是将有歧义的地方根据总结的数据再次计算
总结
这一篇文章总体讲的是背后的数学原理,而不是具体如何训练,确实是很烧脑啊
评论(0)
暂无评论