
引言
这篇文章将简述Diffusion Model的基本用途和基本原理
一. 基本用途
Diffusion Model通常运用在影像的生成上,常见的方式有:
- 文生图:输入一句文字,生成图片,例如 Stable Diffusion 这类模型
- 图生图:给一张已有图片,按照提示词改变风格、内容或细节
- 图像修复 / 补全:把缺失区域补出来,也叫 inpainting
- 超分辨率:把低清图片变得更清晰
- 图像编辑:比如更换背景、改变服装、修改物体
- 视频生成:本质上可以看成在时间维度上生成连续图像
- 3D、音频、语音生成:现在也有很多 diffusion 用在 3D、音乐、语音上。
二. 基本原理
- 1. 总路径
这里主要介绍生成图的方式
你可以先把它理解成一种“从随机噪声出发,逐步生成符合训练数据分布的图像”的生成模型,主要是依靠Denoise逐渐消除图片中的噪点,最后生成目标图片,如图所示
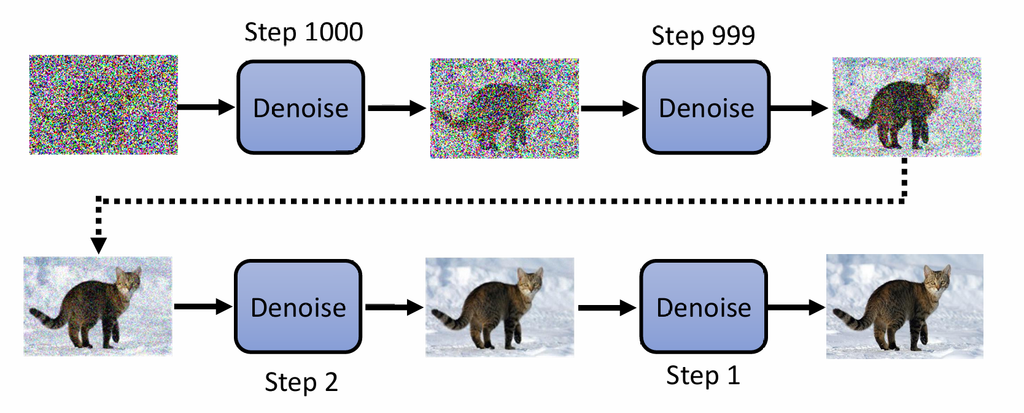
你可以这样理解,相当于雕刻,从一开始是一个大理石,一步一步的就把它雕刻为一座雕像
- 2. Denoise如何运作
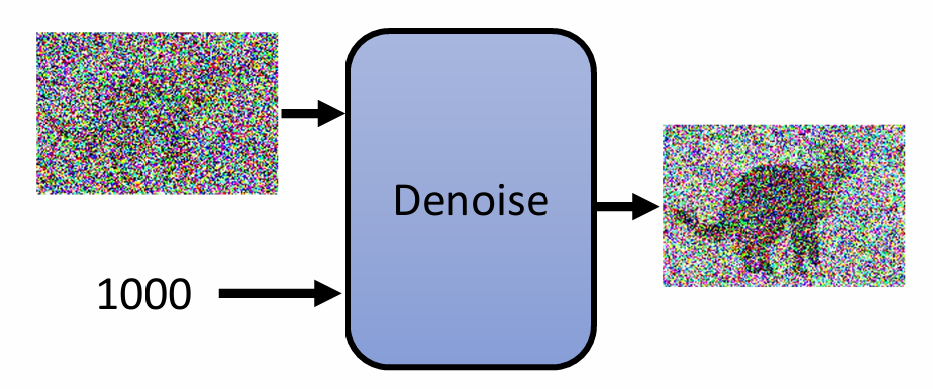
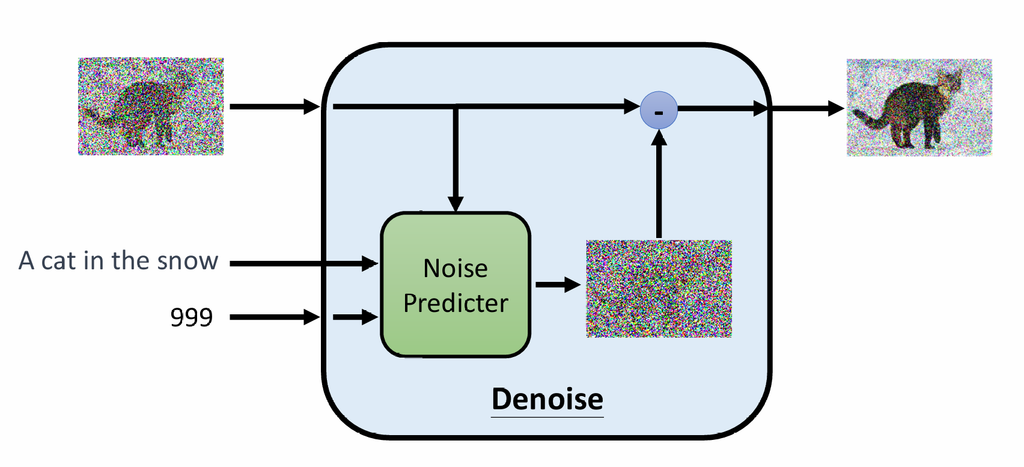
Denoise也并不是简单的将图片放入就可以消除噪点,放入图片的同时还要输入噪点的时间步编号,图中的 1000 是示例的时间步编号,较大的时间步通常对应更强的加噪,如图所示
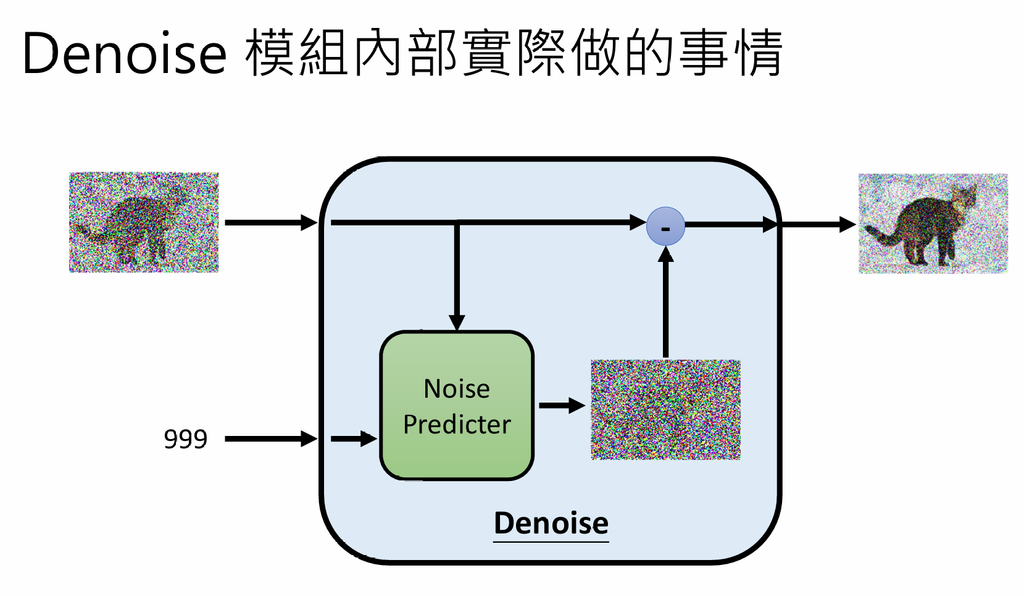
不仅如此,Denoise并不是简单的直接消除噪点,模型根据当前带噪图像和时间步预测噪声,再由采样算法计算下一步图像
预测噪点图的模型叫做Noise Predicter
三. 如何训练Noise Predictor
- 1. 分步拆解
首先我们先了解一次训练是如何形成的
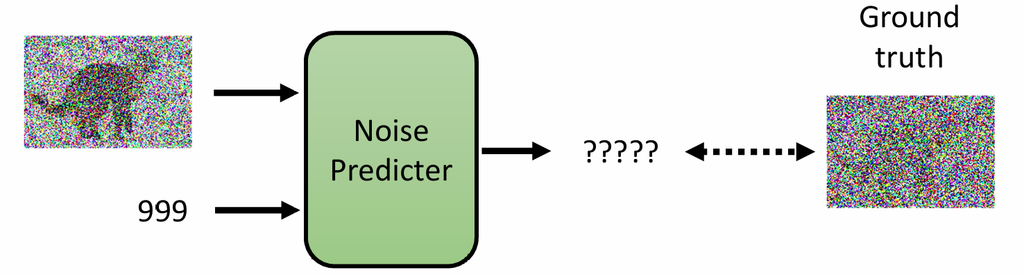
首先输入带噪图像和时间步编号输入Noise Predicter,画图时让“真实噪声”和“预测噪声”一起指向“损失函数”,不要把真实噪声箭头指向模型输入,让它进行学习
- 2. Forward Process
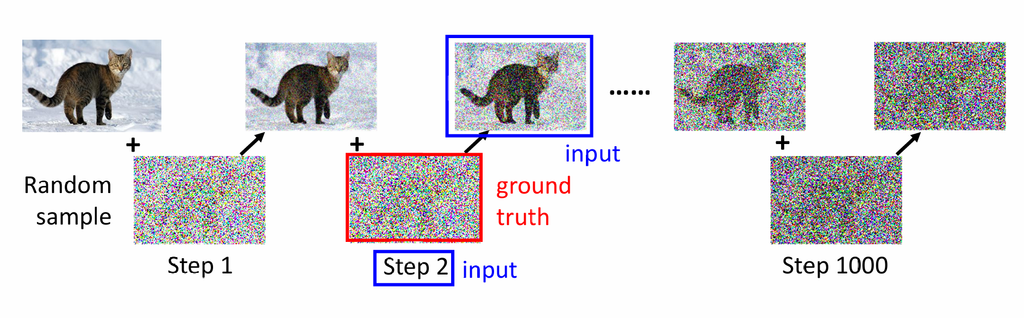
训练时,先取一张真实图像,随机选一个时间步,再采样一份随机噪声
按照预先设定的噪声日程,把噪声加入图像,得到带噪图像 ,噪声预测模型接收和时间步 ,输出预测噪声
我们将预测噪声与刚才实际加入的噪声比较,利用误差更新模型参数,重复这一过程,模型便逐渐学会处理不同噪声水平的图像
我们也没有必要依次从1到1000进行训练,只用随机挑选一定数量的时间步进行训练就可以了
- 3. 其他
如果想训练文字生图的模型,你可以在训练Noise Predicter的过程中加入文字
总结
这只是Diffusion Model的作用和使用方式,接下来将讲解关于Diffusion Model背后的数学原理
评论(0)
暂无评论