
引言
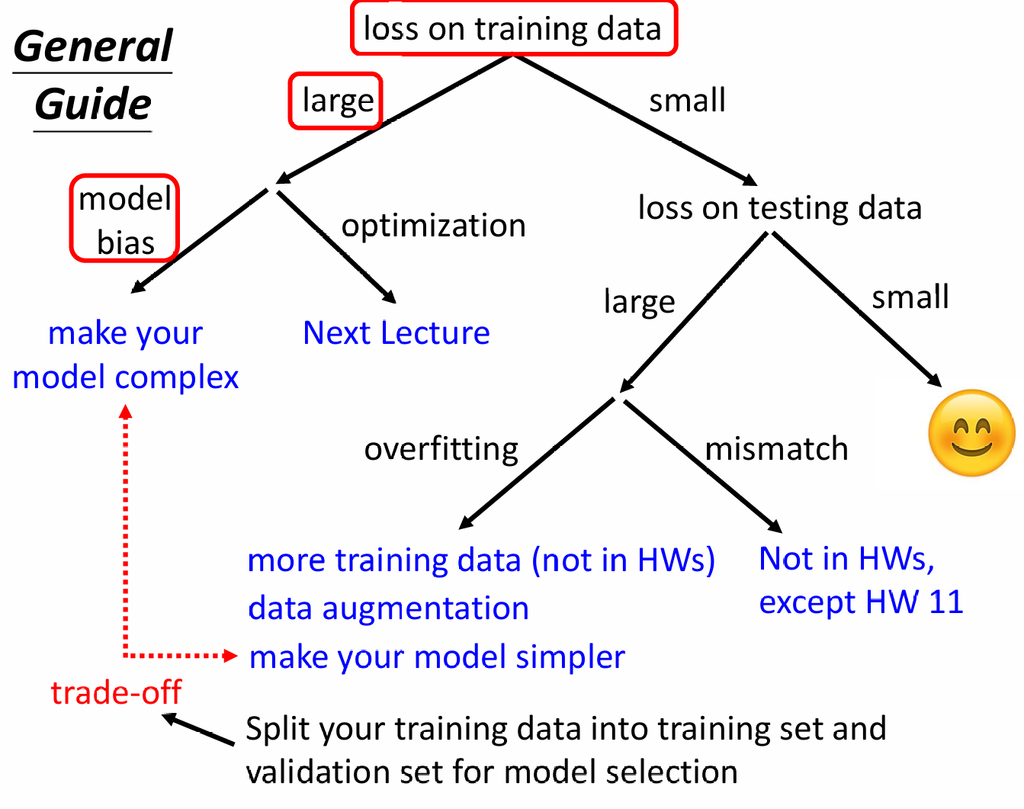
这一篇文章主要是用来解决loss过于大的问题,这里先给出一个总体的表格
1.loss on training data
如果在训练数据上loss就过于大,就往右分支走,有两个方向可以思考,这里给出解决方法
- 1. model bias
优先考虑模型容量不足、特征表达不足或训练不充分,这里的意思是model可能太过于简单了,弹性不够,例如linear model跟piecewise linear的区别,一个是线性的,一个是弹性的,因此可以换一个更富有弹性的model
那么如何测量model呢,其实很简单,就是使用不同的model,主要比较验证集(validation set,后面有详细说明) loss,选择验证集表现较好的模型
- 2. Optimization issue
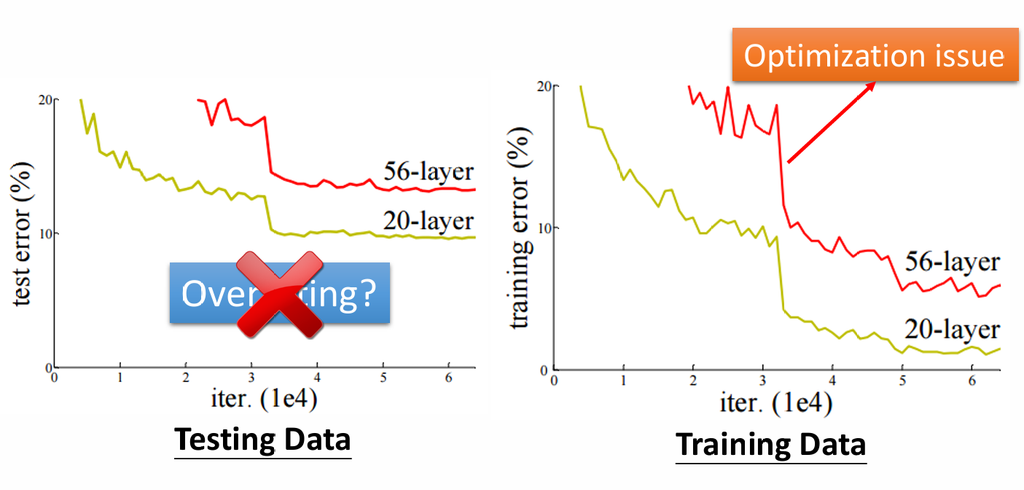
这里的意思是可能问题出在了优化上,如果一个model的layer(深度)很高,但是在training data上loss却更低,这不是overfitting,而是优化出了问题
可以这样思考,高层次的model只需要复制粘贴低层次model的结果,都可以做到loss相同,因此理论上,若模型类严格包含、且优化成功,最优训练损失不应更差,当然这只基于traning data
二.loss on testing data
对于一些模型,在traning data的训练下,loss可能会很低,但是在未知的数据(testing data)中,进行预测的结果跟真实值却相差甚远,也就是loss过大,而造成这样这种问题的同样的也有两种可能性
- 1. overfitting
1.1 定义
前提:training data loss小但是testing data loss大,有些人不看traning data的数据,仅仅只是看到testing data的loss大就觉得是overfitting,但其实可能连前置条件都没有满足
overfitting指的是model弹性过大,造成了数据少,弹性大,自由度过大,结果差
就比如本来就只有三个点,但是却用了很复杂的模型,结果每次画出来的函数图都不一样,因此会造成loss过大,结果差
1.2 解决方法
A. Data augmentation 也就是自己通过规律合理的创造一些新数据资料,例如将照片翻转,照片尺寸改表,但是不能做类似于把照片倒过来之类的错误数据资料
B. 限制模型的弹性
a. 少用一点参数
b. 使用参数共享,例如卷积神经网络在不同位置复用同一组卷积核
c. 给少一点features
d. 更早的结束,也就是适当减少epoch的次数
e. Regularization
f. Dropout
但是不要限制的太大,否则会产生model bias,就会回到上一个问题
- 2. mismatch
指的是训练资料跟测试资料分布差距过大,例如用2013的训练数据去预测2023的数据,就可能会造成loss过大
三. 一些训练方法
- 1. 训练测试方法(cross validation)
也就是拿90%的训练资料去训练模型,剩的10%作为validation set,也就是模拟testing data进行衡量模型的分数,这样就节省了上传kaggle观看testing data loss的步骤
- 2. 进阶
将data分成n等分,再训练n遍,每次用其中一份验证,其余 n−1 份训练,相当于是排列组合了,如图所示
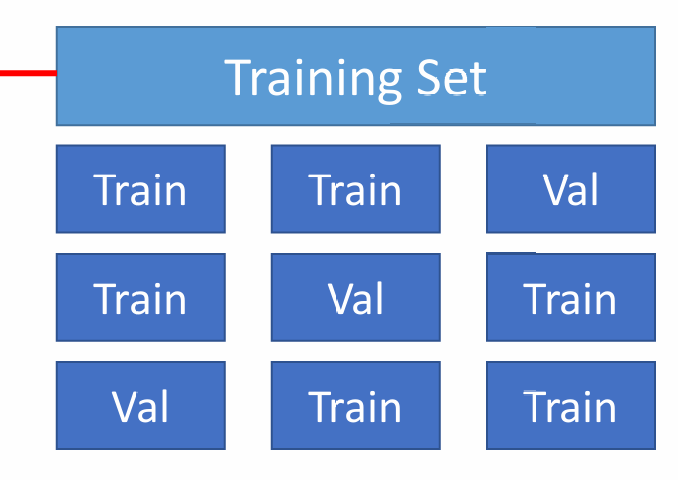
通过这样的方式计算不同的model的loss,就可以对比出最适合的model
总结
先确认训练集是否拟合好;若训练误差高,检查模型容量、特征与优化。若训练误差低而验证误差高,检查过拟合或训练—部署分布不匹配。模型选择只看验证集,测试集(validation set)只在最后使用一次
以上就是在机器学习中会用到的通用流程,希望对你有帮助
评论(0)
暂无评论